Vicsek

Das Vicsek-Modell wurde 1995 vorgeschlagen, um das Schwarmverhalten von Vögeln oder Fischen zu modellieren. Die Idee ist, dass jedes Individuum seine Bewegungsrichtung an der seiner Nachbarn anpasst. Wenn jedes Individuum genügend Nachbarn hat und die Störeinflüsse nicht zu groß sind, bilden sich Schwärme. Videos von solchen Schwärmen werden auf allen größeren Konferenzen der Statistischen Physik gezeigt — und jetzt auch hier.

Auf GitHub findet sich das Programm, das ich für obiges Video geschrieben habe. Es ist in Rust geschrieben und zeigt die Simulation per Piston auf dem Bildschirm.

Ich habe sehr großen Gefallen an Rust gefunden — gerade für ein Projekt wie dieses scheint es ideal geeignet. Es ist so schnell wie C, aber man muss sich keinerlei Gedanken um den Speicher machen und einige andere Fehlerklassen, die der Compiler direkt verhindert. Rayon macht Parallelisierung so einfach wie OpenMP — mit dem Vorteil, dass der Compiler einen Fehler ausgibt, falls es eine Variable gibt, aus der parallel gelesen und geschrieben wird.

Als Beispiel, warum ich Rust als sehr leserlich und elegant empfinde, möchte ich folgendes (unvollständige) Beispiel ansehen.

pub enum Proximity {
    Neighbors(usize),
    Radius(f64)
}

pub struct Vicsek {
    proximity: Proximity,
}

impl Vicsek {
    fn update(bird: &mut Bird) {
        match self.proximity {
            Proximity::Neighbors(n) => self.update_direction_neighbors(bird, n, noise),
            Proximity::Radius(r) => self.update_direction_disk(bird, r, noise),
        }
    }
}

Die Methode update() passt die Richtung an, in die ihr Argument im nächsten Zeitschritt fliegen soll. In meiner Simulation gibt es zwei Möglichkeiten: entweder orientiert man sich an seinen n nächsten Nachbarn oder an allen Vögeln innerhalb eines Radius von r. Der Datentyp Proximity kann eines von beiden beinhalten — welches vorhanden ist, kann elegant per Pattern-Matching ermittelt werden.

Brauche ich länger, um Rust zu schreiben als C oder C++? Vermutlich, aber ich verbringe weniger Zeit mit dem Debuggen. Netto also mehr Spaß.
A Graph a Day

Vor einiger Zeit habe ich @randomGraphs geschrieben: Ein Twitterbot, der einen Zufallsgraphen pro Tag tweetet.

Die meisten Graphtypen, die er darstellen kann stammen aus der NetworkX Bibliothek oder sind reale Netzwerke. Ein paar Proximity Graphs habe ich selbst geschrieben. Die Darstellung und gegebenenfalls das Layout übernimmt Cytoscape oder graph-tool (dessen Autor diesem Bot folgt).

Bei diesem Projekt habe ich exzessiv Gebrauch von Pythons Decorator und Introspection gemacht, sodass man, um einen neuen Graphtyp einzuführen nur eine Methode schreiben muss, die eine Graph-Datenstruktur zurück gibt. Einstellungen, welche Darstellungen erlaubt sind, werden per decorator getätigt und alle Methoden werden per Introspection automatisch zum Pool hinzugefügt, aus dem der Zufallsgenerator zieht.

Eine typische Methode sieht etwa so aus.

@synonym("Barabasi Albert")
@synonym("preferential attachment")
@style(styles_all)
@layout(["kamada-kawai", "force-directed", "sfdp", "fruchterman_reingold", "arf", "radial_tree"])
def generateBarabasiAlbert(self, N=None, m=None, **kwargs):
    if N is None: N = random.randint(4, 400)
    if m is None: m = random.randint(1, 5)

    G = gen.barabasi_albert_graph(N, m)  # gen is networkx Generator
    details = dict(name="Barabási-Albert Graph", N=N, m=m, seed=self.seed,
                   template="{name}, N = {N}, m = {m}")

    return G, details

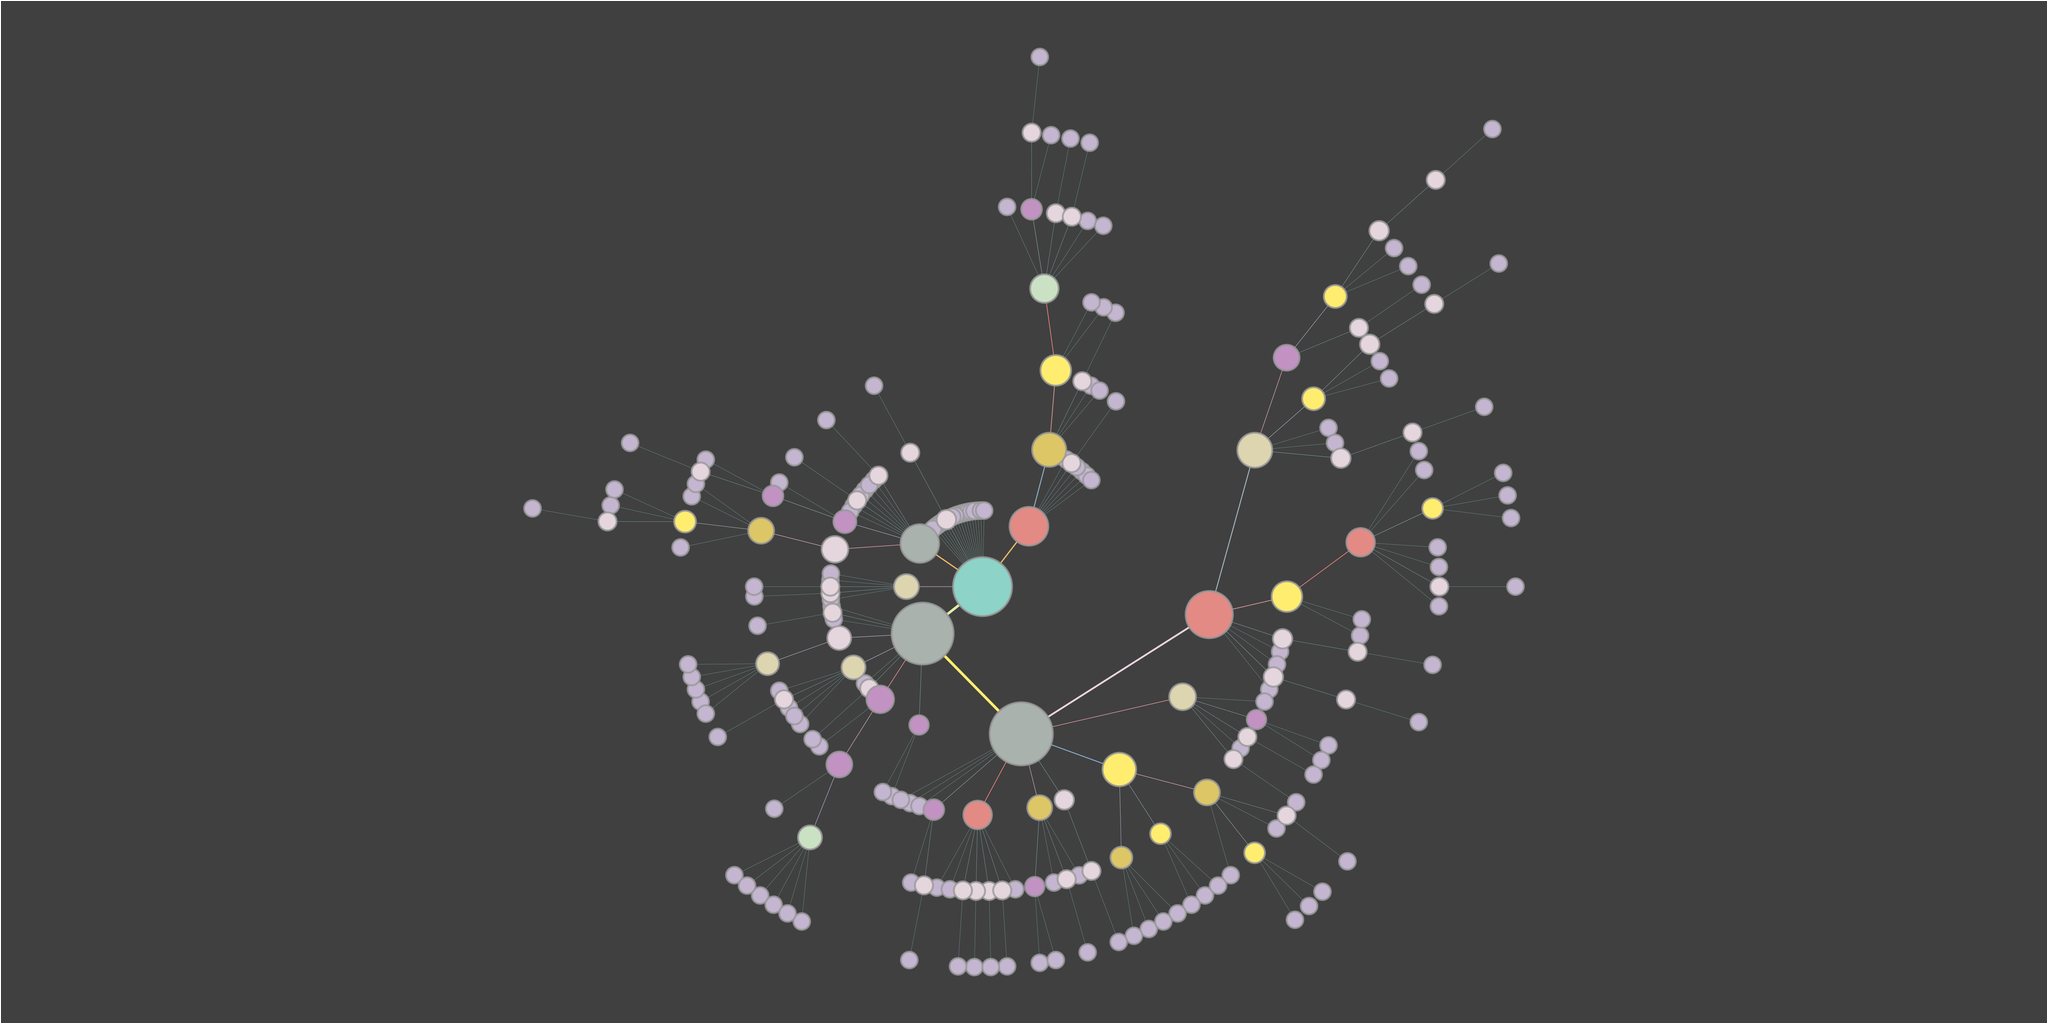
Und liefert für $N=226, m=1$ und das radial_tree Layout beispielsweise diesen Graph. Die Größe der Knoten wird hier von der Betweenness Centrality bestimmt.

Graph

Die @synonym Decorators ermöglichen die zweite Funktion des Bots, denn er tweetet nicht nur einmal am Tag einen zufälligen Graphen, sondern reagiert auch auf Mentions. Falls in der Mention der Name der Methode oder eines der per @synonym registrierten Worte auftaucht, antwortet er mit einem Bild des entsprechenden Graphen. Dank fuzzywuzzy ist es sogar resistent gegen Tippfehler.

Twitter unterstützt leider keine Vektorgrafiken und wandelt Bilder gerne in stark komprimierte .jpg, was gerade bei diesen Graphen zu störenden Artefakten führt. Dagegen hilft es, wenn ich einen Rand aus transparenten Pixeln dem Bild hinzufüge. Das führt dazu, dass Twitter .jpg nicht als geeignetes Format ansieht und die Bilder im verlustfreien .png ausliefert.

convert -alpha on -channel RGBA -bordercolor "rgba(0,0,0,0)" -border "1x1" input.png output.png

Graph

Der komplette Quellcode ist auf Github.

SimulatedSort

Simulated Annealing ist eine Optimierungsmethode, die von natürlichen Kristallisationsprozessen inspiriert ist. Man startet in der Schmelze bei hohen Temperaturen und lässt es dann abkühlen, sodass die Atome sich in einem Zustand minimaler Energie anordnen, dem Kristallgitter. Wenn man also für ein Optimierungsproblem die zu optimierende Größe als Energie ansieht, und man eine Lösung durch eine kleine Änderung in eine andere Lösung verwandeln kann, kann man mit dieser Methode eine Näherung für das Optimum finden.

Wenn wir also eine Sequenz $S$ von $N$ Zahlen sortieren wollen, können wir die Summe der Differenzen zwischen benachbarten Zahlen als Energie betrachten, denn die ist minimal in einer sortierten Liste. \begin{equation} \mathcal{H} = \sum_{i=1}^{N-1} \left| S_i - S_{i+1} \right| \end{equation} Um eine Lösung in eine andere zu verwandeln, reicht es zwei Elemente der Sequenz zu tauschen.

Der Kern von Simulated Annealing ist der Metropolis Algorithmus.

  1. Starte bei einer hohen Temperatur $T$.
  2. Berechne die Energie $\mathcal{H}(S)$ der aktuellen Konfiguration $S$.
  3. Erzeuge eine neue Konfiguration $R$ durch eine kleine Änderunge von $S$.
  4. Akzeptiere $R$ mit der Wahscheinlichkeit $$p_\mathrm{acc} = \min\left[1 ,\exp(-(\mathcal{H}(R) - \mathcal{H}(S))/T) \right],$$ sodass eine „sortiertere“ Sequenz immer akzeptiert wird und eine „unsortiertere“ vor allem bei hohen Temperaturen. Wenn $R$ akzeptiert wird, gilt $S:=R$, ansonsten wir die alte Konfiguration $S$ weiter benutzt.
  5. Reduziere die Temperatur (beispielsweise durch Multiplikation mit einer Zahl etwas kleiner als 1) und breche ab, wenn die Zieltemperatur erreicht ist. Ansonsten beginne wieder bei Punkt 2.

Genug der Theorie: In einem Gist auf GitHub präsentiere ich ein schnell terminierendes Sortierprogramm, das zwar nicht immer eine sortierte Liste findet, aber zumindest eine Näherung! Es ist also Bogosort in mehr als nur einer Hinsicht überlegen!

Wer braucht da noch $\mathcal{O}(N \log(N))$ Sortier-Algorithmen?!