Number of longest increasing subsequences

Meine liebsten Probleme sind solche, die einfach scheinen aber sehr tief sind. Natürlich gehört das Problem des Handlungsreisenden dazu: Es ist einfach zu verstehen, dass der Müllmann bei jeder Mülltonne vorbei muss und dabei möglichst wenig Strecke fahren will. Gerade deshalb ist es das Paradebeispiel für NP-schwere Probleme (technisch gesehen ist nur seine Entscheidungs-Version „Gibt es eine Tour, die kürzer ist als $X$“ NP-schwer und nicht die typische Optimierungsversion: „Welche ist die kürzeste Tour“).

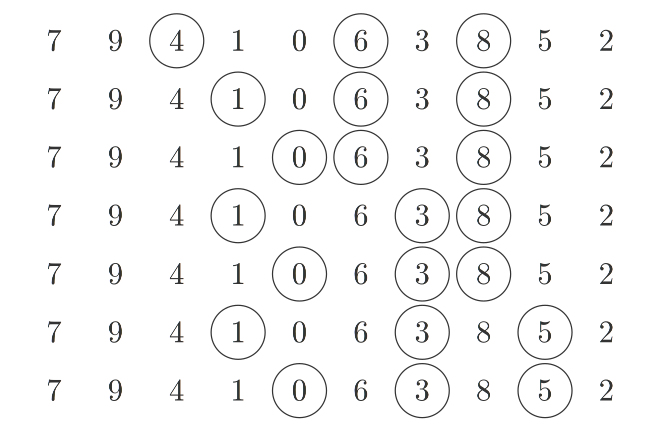
Aber fast noch besser gefällt mir das Problem der längsten aufsteigenden Teilfolge, oder auf englisch, longest increasing subsequence (LIS): Gegeben eine Folge von Zahlen $S_i$, welche Teilfolge ist am längsten unter der Bedingung, dass die Zahlen aufsteigen.

Eine längste aufsteigende Teilfolge ist in einer Folge markiert

Dieses Problem ist so einfach, dass es erstmals von Stanisław Ulam als Fingerübung beschrieben wurde und nach meinem Eindruck heutzutage als Übung für dynamische Programmierung in Universitäten verwendet wird. Wer weiß wie viele Bewerber vor einem Whiteboard ins Schwitzen geraten sind bei dem Versuch es aus dem Stegreif zu lösen.

The Surprising Mathematics of Longest Increasing Subsequences -- Dan Romik

Auf der anderen Seite ist es aber offenbar tief genug, dass man ganze Bücher darüber schreiben kann. Es zeigen sich überraschende Querverbindungen zu scheinbar unabhängigen Problemen. Denn die Länge $L$ der LIS einer Permutation fluktuiert genauso wie der Abstand von der Mitte zum Rand eines Kaffeeflecks oder die größten Eigenwerte von Zufallsmatrizen.

Nun ist die Lösung dieses Problems nicht eindeutig: Es kann viele längste aufsteigende Teilfolgen geben. Tatsächlich wächst die Anzahl sogar exponentiell mit der Länge der ursprünglichen Sequenz.

Verschiedene längste aufsteigende Teilfolgen der gleichen Folge

Allerdings wurde bisher nie untersucht wie viele genau. Oftmals hört man, es sei nicht praktikabel alle durchzuzählen, da es exponentiell viele seien. Und wenn es darum ginge alle zu enumerieren, würde das stimmen. Aber wir wollen an dieser Stelle nur die Anzahl wissen, die wir mittels dynamischer Programmierung effizient bestimmen können. Die Idee ist, dass wir für jedes Element, das an Position $x$ in einer LIS auftauchen kann, berechnen, wie viele aufsteigende Teilfolgen der Länge $L-x$ mit diesem Element beginnen.

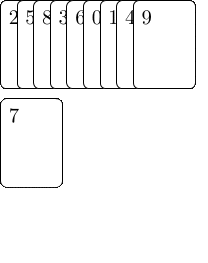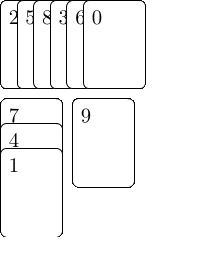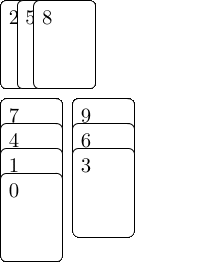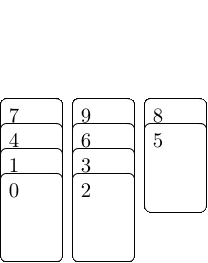
Besonders einfach geht das, wenn wir zuerst eine Datenstruktur aufbauen, die kodiert welche Elemente in einer LIS aufeinander folgen können. Dazu erweitern wir Patience Sort, und da dieser Algorithmus nach einem Kartenspiel benannt ist, werden wir es auch mit Karten visualisieren: Wir schreiben jedes Element unserer Sequenz auf eine Karte und legen die Karten auf einen Stapel, sodass das erste Element der Sequenz oben liegt. Dann nehmen wir Karten von oben ab und legen sie auf verschiedene Stapel. Die erste Karte legen wir auf den ersten, noch leeren Stapel. Die folgenden Karten legen wir auf den ersten Stapel, dessen oberstes Element größer ist als die aktuelle Karte und ansonsten machen wir einen neuen Stapel rechts davon auf. Jedes mal wenn wir eine Karte ablegen, lassen wir sie auf alle Karten, die aktuell auf dem Vorgängerstapel liegen und kleiner sind, zeigen — dies sind die Karten die in einer aufsteigenden längsten Teilfolge direkt vor ihr auftauchen können.

Animation von Patience Sort

Am Ende haben wir $L$ Stapel, wobei $L$ die Länge der LIS ist, und wir können vom Stapel ganz rechts starten und den Pfeilen folgen, um eine LIS zusammenzubauen. Wenn wir nur an der Länge interessiert wären, müssten wir uns über den Inhalt der Stapel keine Gedanken machen und der Algorithmus ließe sich sehr kompakt darstellen:

fn lis_len<T: Ord>(seq: &[T]) -> usize {
    let mut stacks = Vec::new();
    for i in seq {
        let pos = stacks.binary_search(&i)
            .err()
            .expect("Encountered non-unique element in sequence!");
        if pos == stacks.len() {
            stacks.push(i);
        } else {
            stacks[pos] = i;
        }
    }
    stacks.len()
}

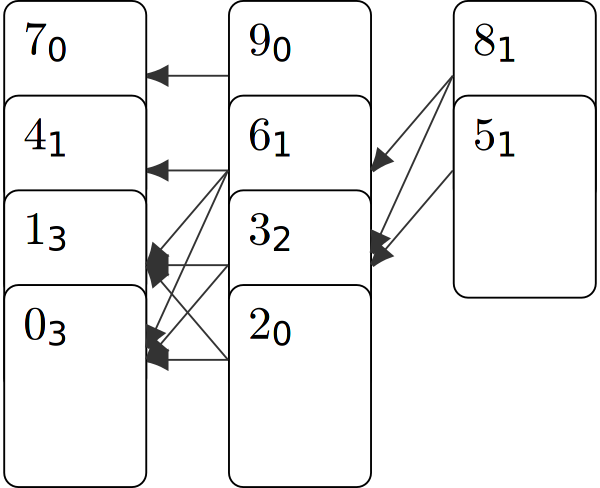
Aber wir wollen mehr, deshalb notieren wir uns im nächsten Schritt bei allen Karten des rechtesten Stapels wie viele aufsteigende Teilfolgen der Länge $x=1$ mit ihnen starten, was trivialerweise je eine ist. Dann notieren wir bei allen Karten des Stapels links davon wie viele aufsteigenden Teilfolgen der Länge 2 mit ihnen anfangen. Das können wir berechnen, indem wir den Pfeilen rückwärts folgen und die Annotationen jeweils aufaddieren. Nachdem wir dies für alle Stapel wiederholt haben und den linkesten Stapel beschriftet haben, können wir alle Annotationen des linkesten Stapels aufaddieren, um die gesamte Anzahl LIS zu erhalten: hier $7$.

Beispiel der Datenstruktur zum Zählen der unterschiedlichen LIS

Wie sich das ganze für längere Sequenzen aus unterschiedlichen Zufallsensembles im Detail verhält haben wir in einem Artikel veröffentlicht.

Phase Transitions of Traveling Salesperson Problems solved with Linear Programming and Cutting Planes

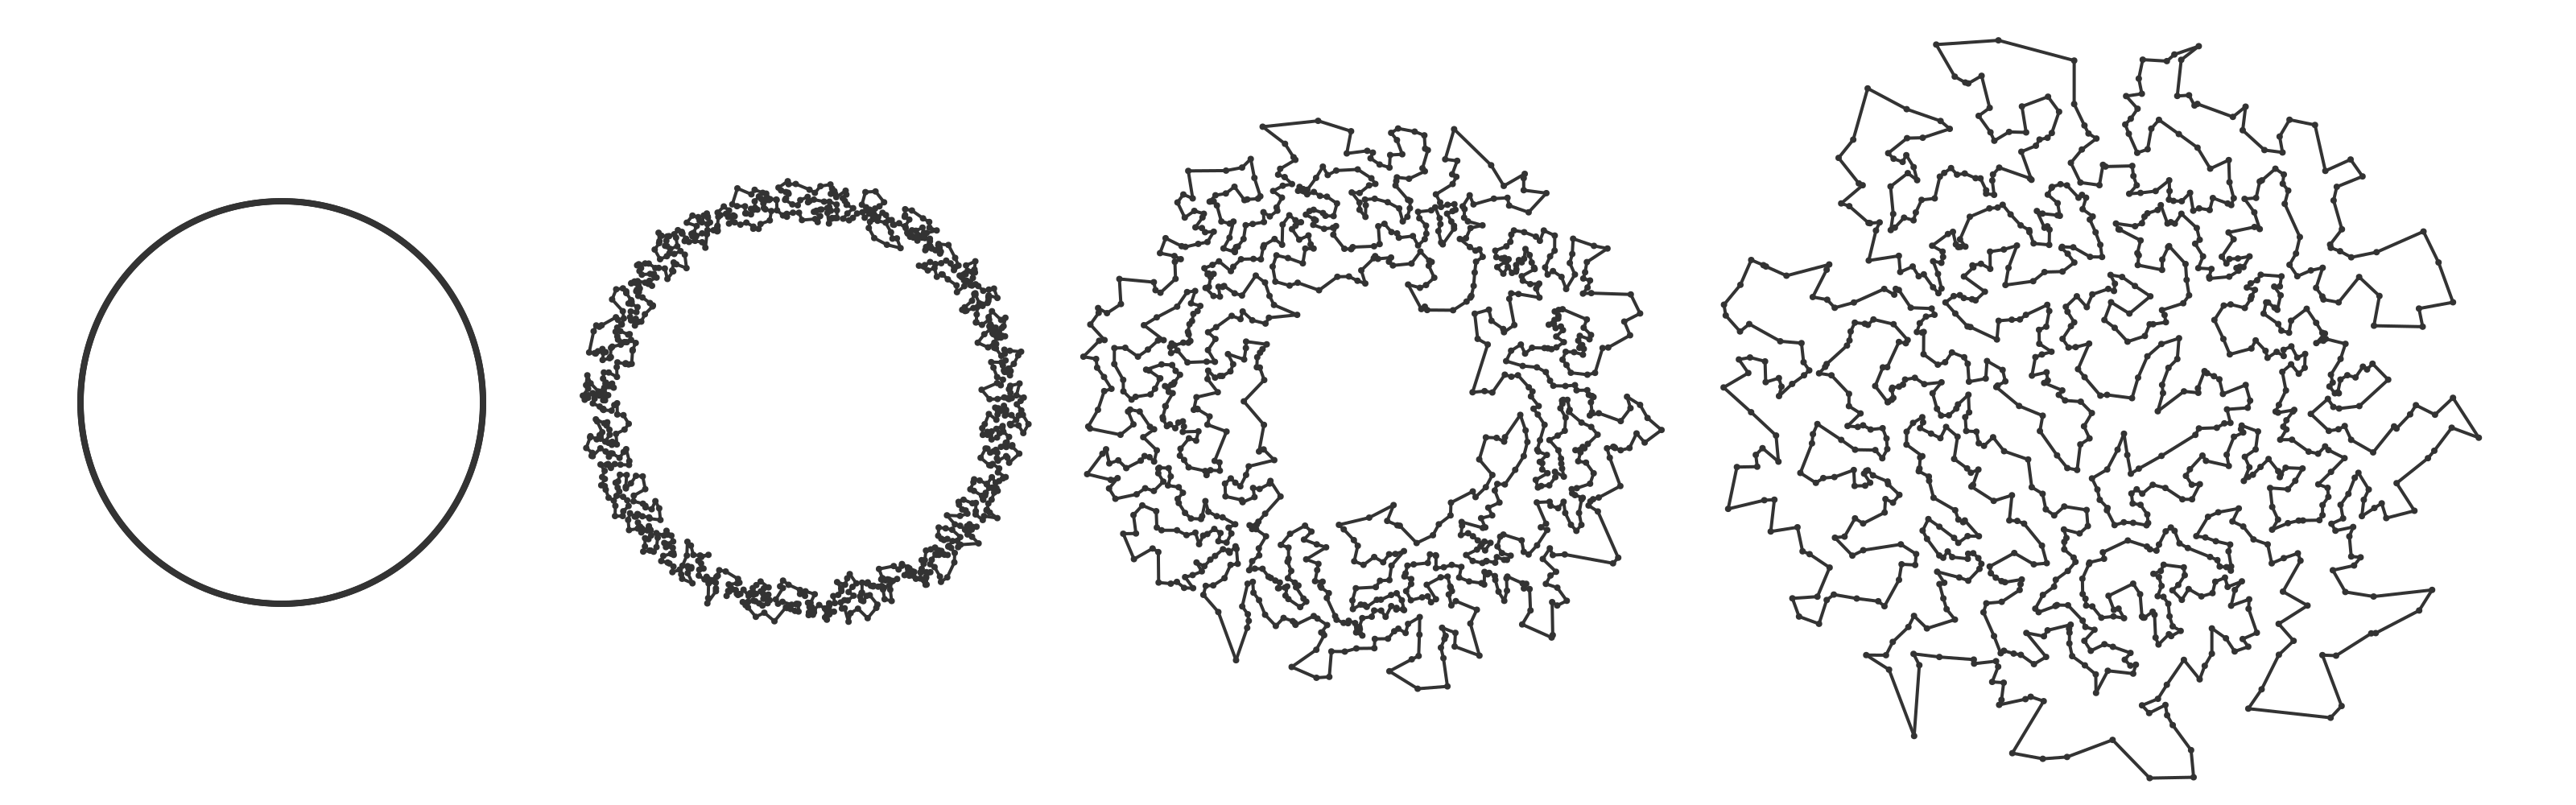
In diesem Artikel wird ein Ensemble von Problemen des Handlungsreisenden (TSP) eingeführt, das abhängig von einem Parameter $\sigma$ von einer trivial einfach zu lösenden Konfiguration, nämlich Städte, die äquidistant auf einem Kreis angeordnet sind, zum zufälligen euklidischen TSP in der Ebene interpoliert.

Einfach und schwierig zu lösende TSP Konfigurationen

Danach werden mittels linearer Programmierung einige Phasenübergänge festgestellt, ab welchen Werten von $\sigma$ das Problem schwierig zu lösen wird. Zu zwei dieser Übergänge werden strukturelle Eigenschaften der optimalen Lösung gefunden, die sich an dieser Stelle ebenfalls charakteristisch ändern. Da die optimale Lösung nicht von der Lösungsmethode abhängt, sind diese Phasenübergänge also nicht nur von Bedeutung für das spezielle Lineare Programm bzw. den Algorithmus der zu dessen Lösung genutzt wurde, sondern fundamentale Eigenschaft dieses TSP Ensembles.

Im Detail haben wir die klassische Formulierung von Dantzig genutzt: \begin{align} \label{eq:objective} &\text{minimize} & \sum_i \sum_{j<i} c_{ij} x_{ij}\ \label{eq:int} &\text{subject to} & x_{ij} &\in {0,1}\ %\mathbb{Z}\ \label{eq:inout} & & \sum_{j} x_{ij} &= 2& & \forall i \in V \ \label{eq:sec} & & \sum_{i \in S, j \notin S} x_{ij} &\ge 2& & \forall S \varsubsetneq V, S \ne \varnothing \end{align}

Hier ist $c_{ij}$ die Distanzmatrix zwischen allen Paaren von Städten aus $V$ und $x_{ij}$ die gesuchte Adjazenzmatrix, also $x_{ij} = 1$, wenn $i$ und $j$ aufeinanderfolgende Stationen der Tour sind und $x_{ij} = 0$ sonst. Die erste Zeile minimiert also die Strecke der Tour. Um zu vermeiden, dass wir die triviale Lösung $x_{ij}=0$, also „wenn wir zu Hause bleiben müssen wir am wenigsten Strecke zurücklegen“ finden, zwingt die dritte Zeile unseren Handlungsreisenden seine Tour so zu planen, dass in Summe zwei Striche an jede Stadt gezeichnet werden — genug, um hinein und wieder hinaus zu reisen. Allerdings, ist unser Handlungsreisender clever und würde versuchen uns auszutricksen, indem er halbe Striche einzeichnen würde, wie in einem anderen Blogeintrag visualisiert. Deshalb ist die Bedingung in der zweiten Zeile nötig, die die Einträge in der Adjazenzmatrix auf ganze Zahlen beschränkt. Dann bleibt nur noch das Problem, dass mehrere Routen, die nicht verbunden sind erlaubt wären, sodass wir sie durch die letzte Zeile verbieten: die Subtour Elimination Constraints. Der aufmerksame Leser mag schon erkannt haben, dass es für jede Untermenge von Städten so eine Constraint definiert, also exponentiell viele in der Anzahl der Städte. Die Lösung zu dieses Problem liegt darin, dass nur sehr wenige wirklich gebraucht werden, sodass man das Problem ohne diese Constraint löst, testet ob eine verletzt ist, was mittels der Berechnung eines minimum cut sehr schnell geht und dann eine einzelne Constraint, die diese Konfiguration verbietet hinzufügt. Diese Methode iterativ Constraints hinzuzufügen wird meist als Cutting Planes bezeichnet.

Also haben wir einen schnellen Algorithmus für das Problem des Handlungsreisenden gefunden? Nein, leider können wir den Millenium Preis noch nicht beanspruchen. Es gibt keinen bekannten Algorithmus, der dieses Problem unter Erfüllung der zweiten Zeilen, also Beschränkung auf ganzzahlige Lösungen lösen kann. Aber sobald wir diese Bedingung fallen lassen, können wir klassische Verfahren der linearen Programmierung nutzen, um dieses Problem effizient zu lösen. Dies wird auch Relaxation genannt. Die Länge der Strecke ist immer eine untere Schranke für die tatsächliche Lösung. Und wenn unsere Lösung per Zufall ganzzahlig ist, können wir uns sicher sein, die Optimale Lösung gefunden zu haben.

Als Ordnungsparameter des Phasenübergangs zwischen leichten und schweren Konfigurationen dient uns also die Wahrscheinlichkeit, dass mittels eines Simplex-Solvers eine ganzzahlige, und damit optimale, Lösung gefunden wird. Ohne die Subtour Elimination Constraints, fällt der Phasenübergang auf den Punkt, an dem sich die optimale Lösung erstmals von der Reihenfolge der Städte des ursprünglichen Kreises unterscheidet. Mit den Subtour Elimination Constraints, fällt der Phasenübergang auf den Punkt, wo die optimale Tour anfängt von einem Zickzack-Kurs auf große Meander zu wechseln. Dies wird durch die geometrische Gewundenheit, die Tortuosität, \begin{align} \tau = \frac{n-1}{L} \sum_{i=1}^{n} \left( \frac{L_i}{S_i}-1 \right). \end{align} ermittelt, die an diesem Punkt maximal wird. Hier wird die Tour in $N$ Teilstücke mit gleichem Vorzeichen der Krümmung unterteilt und für jedes Teilstück das Verhältnis von direkter Ende-zu-Ende-Distanz $S_i$ zu der Länge entlang der Tour $L-i$ summiert.

Wir haben also kontinuierliche Phasenübergänge in der Schwierigkeit dieses Problems mittels linearer Programmierung detektiert und sie mit strukturellen Änderungen des Verhaltens in Verbindung gebracht.

A Fractal A Day

Vor einiger Zeit habe ich ein Programm geschrieben, das verschiedene Typen von Fraktalen generiert. Da viele Methoden Fraktale zu generieren relativ einfach zu parallelisieren sind und großen Bedarf an Rechenkraft haben, habe ich mich entschieden es in Rust zu implementieren. Bei Interesse kann das Programm von Github bezogen werden.

Da Fraktale nett anzuschauen sind, ist dieser Beitrag voller hochaufgelöster Bilder. Damit diese Seite dennoch flüssig geladen wird — auch bei langsamen Verbindungen, habe ich extra für diesen Eintrag in die Technik dieses Blogs eingegriffen. Außerdem gibt es @AFractalADay auf Twitter, der täglich ein zufälliges Fraktal tweetet.

Escape Time

Die erste Klasse von Fraktalen, die ich hier zeigen möchte, wird definiert durch das Konvergenzverhalten des wiederholten Anwendens einer Funktion. Was genau dieser Satz bedeutet, lässt sich am besten an einem Beispiel erklären.

Mandelbrot-Menge

Das vermutlich bekannteste Fraktal ist das Apfelmännchen, das die Mandelbrotmenge visualisiert. Das ist die Menge der komplexen Zahlen $c = x + iy,$ die nicht konvergieren, wenn die Funktion $f_c(z) = z^2 + c$ wiederholt angewendet wird. Also wenn die Folge $$f_c(0), f_c(f_c(0)), f_c(f_c(f_c(0))), …$$ gegen einen endlichen Wert strebt.

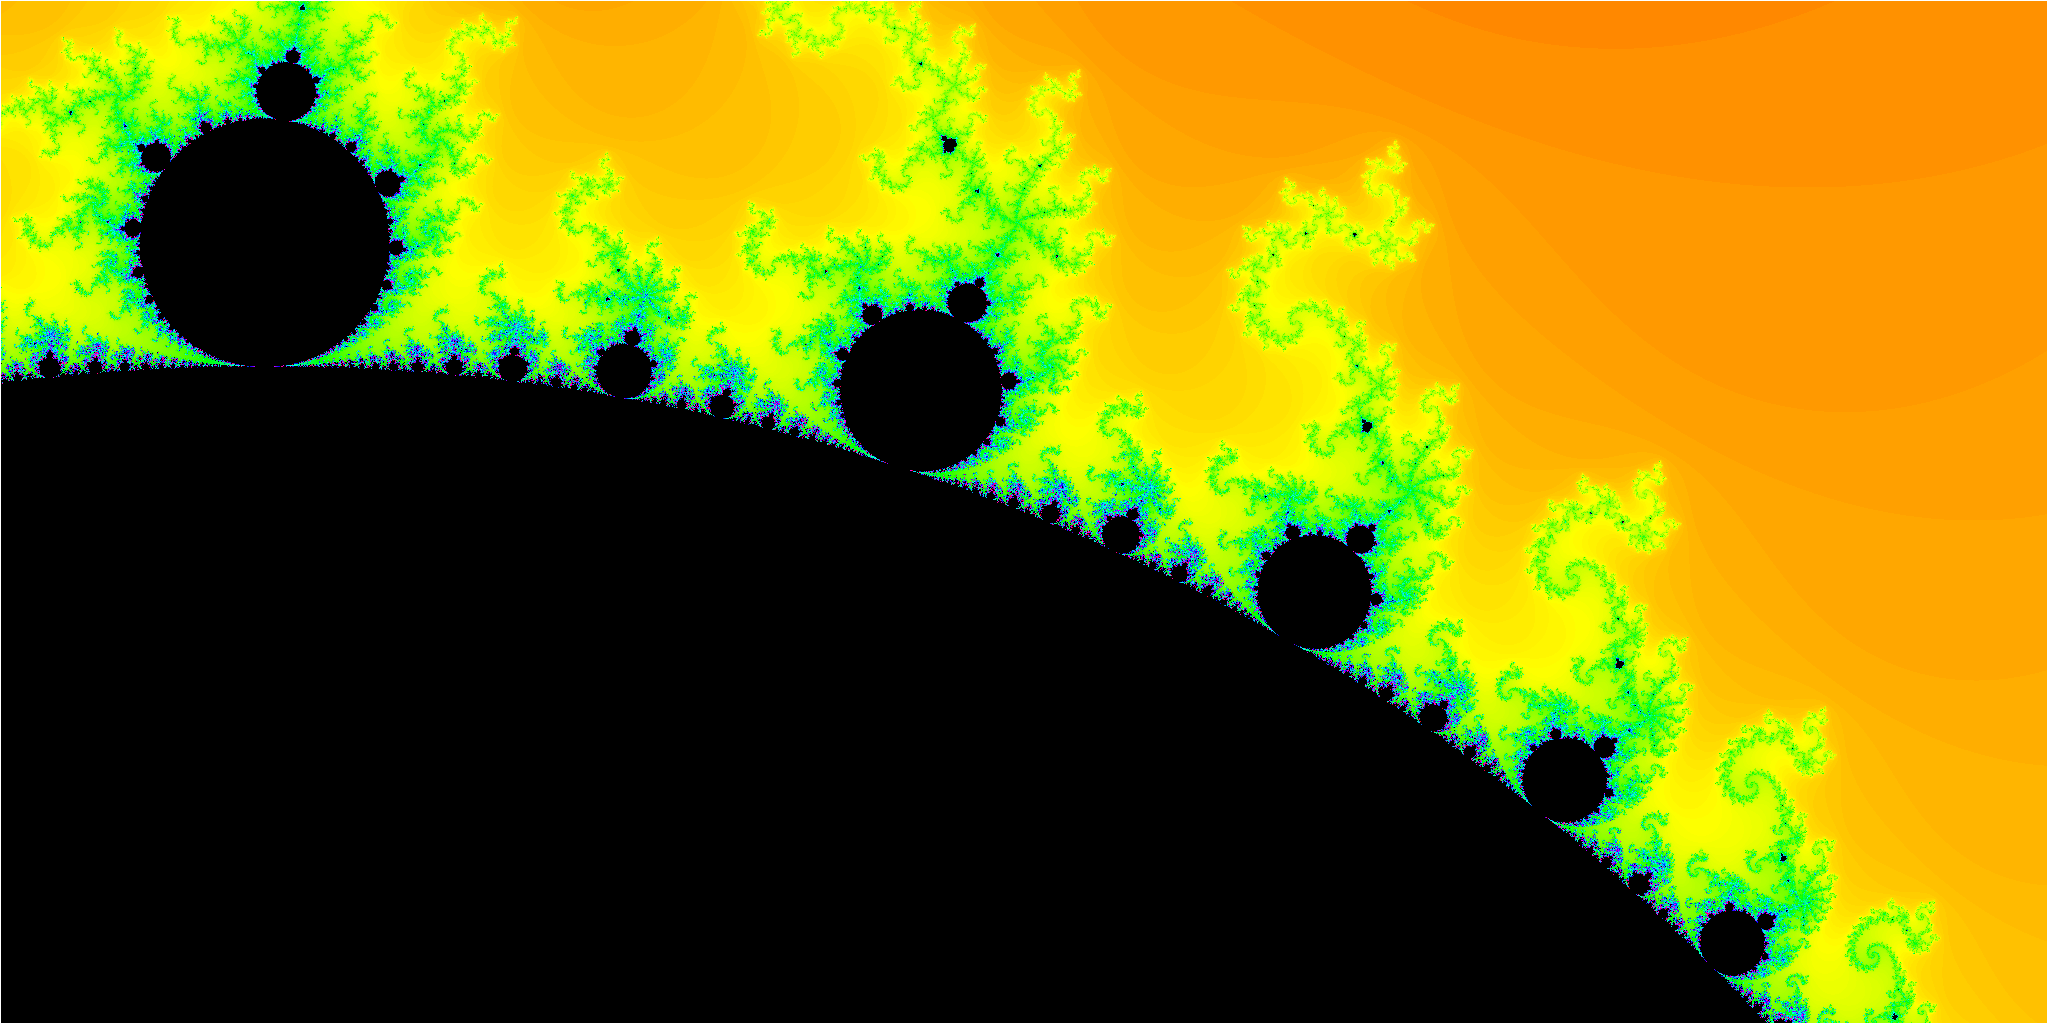
Wenn man jeden Punkt $c$ auf der komplexen Ebene entsprechend des Konvergenzverhaltens bezüglich dieser Folge einfärbt — schwarz wenn es konvergiert, blau für langsame Divergenz, rot für schnelle Divergenz — erhält man ein solches Bild:
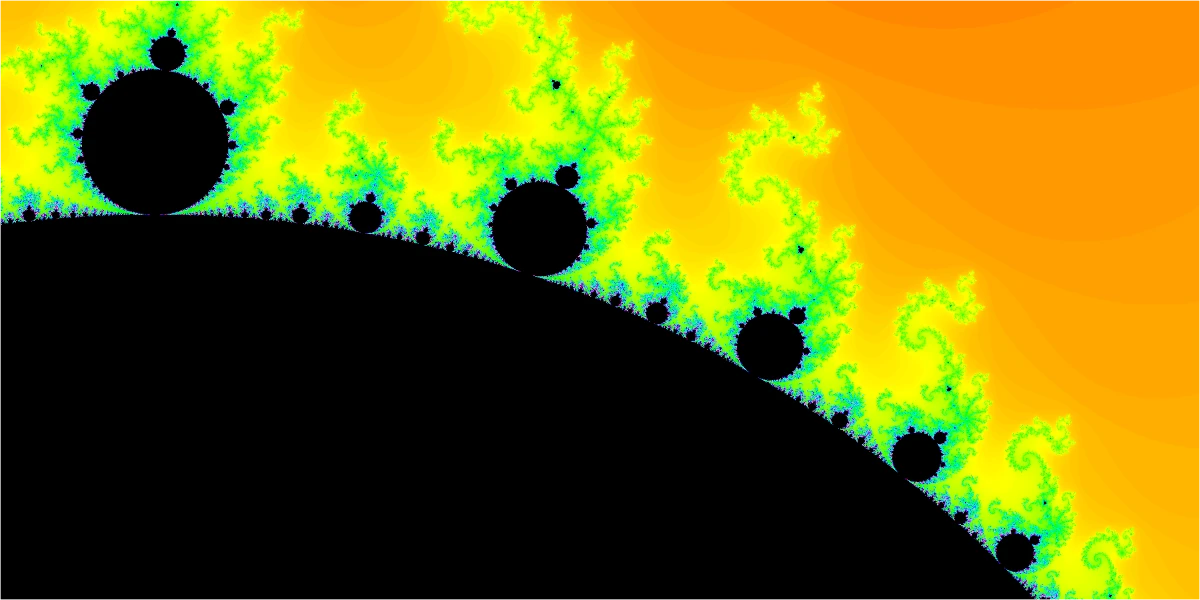
Zoom auf das Apfelmännchen

Dies ist ein Zoom auf den Rand des Apfelmännchens. Tatsächlich ist die Mandelbrotmenge kein Fraktal im eigentlichen Sinne, da seine fraktale Dimension 2 ist — der schwarze Bereich füllt eine Fläche.

Es einfach möglich dieses Fraktal zu rastern und dabei jeden Pixel parallel zu berechnen. Eine naive Implementierung könnte wie folgt aussehen.

// convenient iterators
#[macro_use] extern crate itertools;
use itertools::Itertools;

// parallelism
extern crate rayon;
use rayon::prelude::*;

// complex numbers
extern crate num;
use num::complex::Complex;

fn raster(resolution: (u32, u32)) -> Vec<u64> {
    let (x, y) = resolution;

    // generate the points, we want to raster
    let pixels: Vec<(u32, u32)> = iproduct!(0..y, 0..x).collect();

    // start a parallel iterator on the points ...
    pixels.par_iter()
          .map(|&(j, i)| {
              // ... mapping every point ...
              let z = map_to_cplx_plane(i, j);
              // ... to the number of iterations needed to diverge
              time_to_diverge(z)
          })
          .collect()
}

fn map_to_cplx_plane(x: u32, y u32) -> Complex<f64> {
    // TODO: here we need to get the offset and scale somehow
    let x = (x-x_offset) as f64 * x_scale;
    let y = (y-y_offset) as f64 * y_scale;
    Complex<f64> {re: x, im: y}
}

fn time_to_diverge(mut state: Complex<f64>) -> u64 {
    // threshold is 2^2, since we compare to the square of the norm
    // as soon as the norm is >= 2 it is sure to diverge
    let threshold = 4.;

    // abort after 1000 iterations
    let max_count = 1000;

    let c = state;

    let mut ctr = 0u64;
    while {
        state = state * state + c;
        ctr += 1;

        state.norm_sqr() < threshold && ctr < max_count
    } {}
    ctr
}

Julia-Mengen

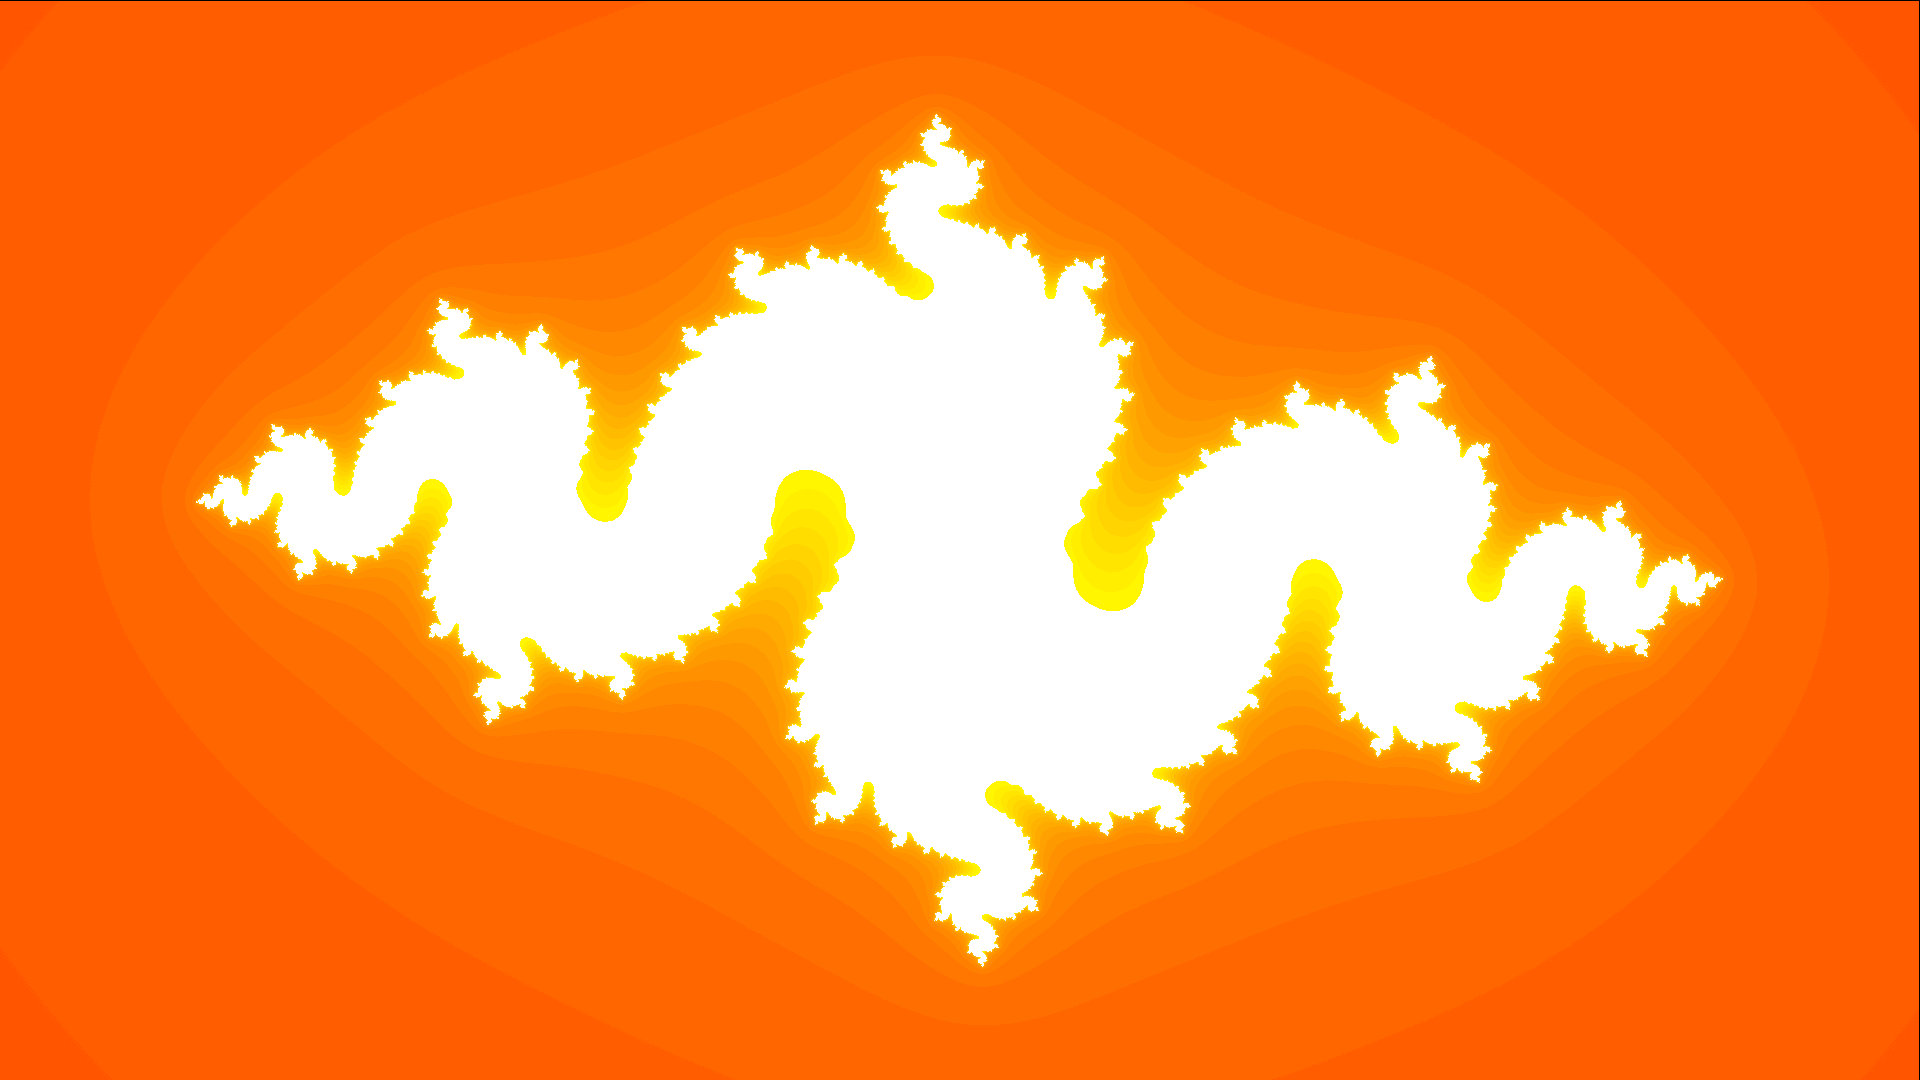
Nahe verwandt sind die Julia-Mengen. Hier benutzt man die gleiche Funktion $f_c$, allerdings färbt man jeden Punkt $z$ entsprechend seines Konvergenzverhaltens bei einem festen Parameter $c$.
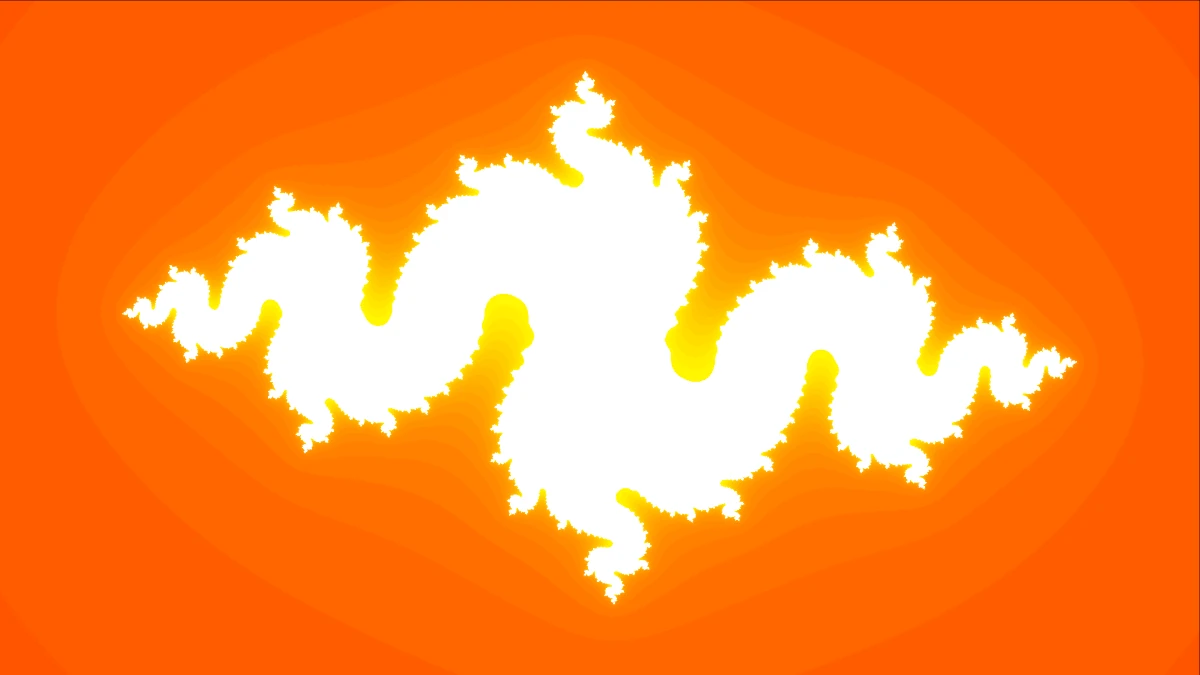
Ein Julia-Fraktal

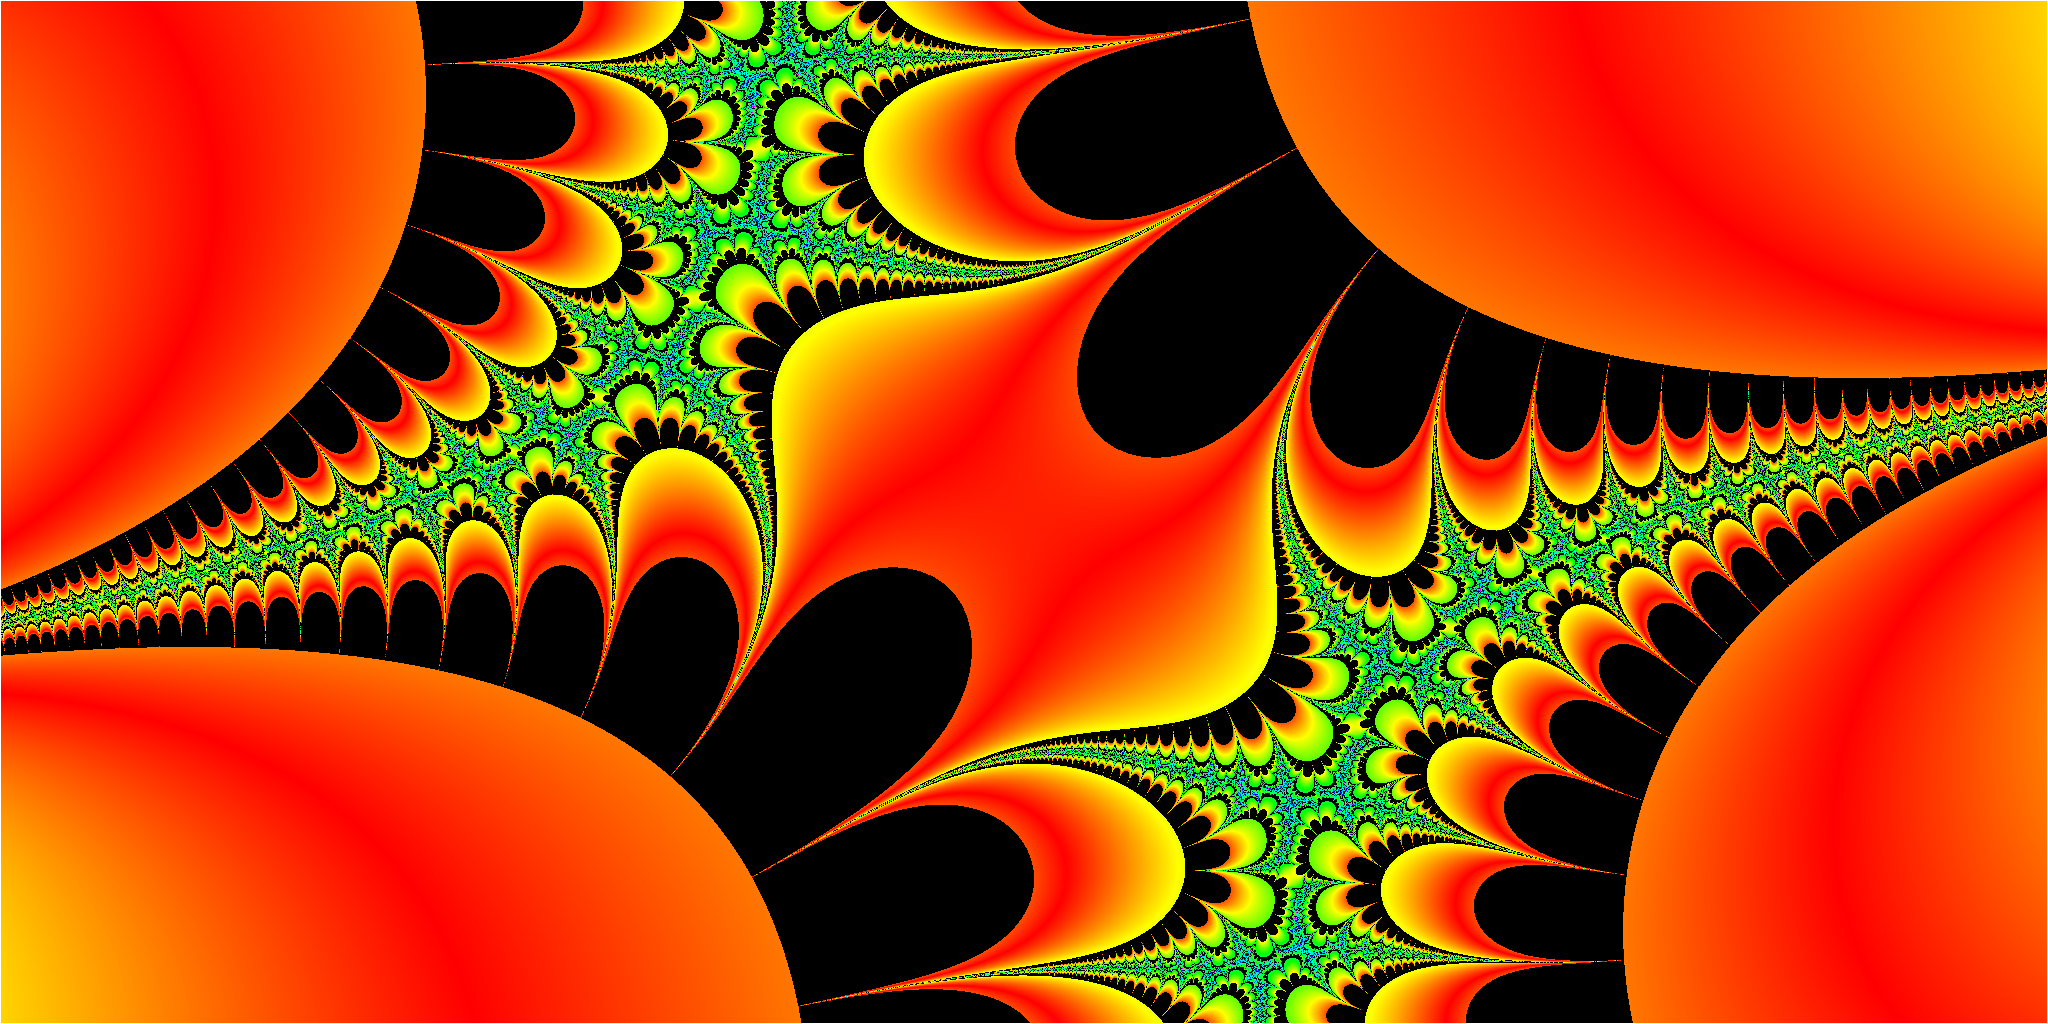
Tatsächlich ist jede beliebige Funktion $f$ erlaubt und nicht nur die oben erwähnte quadratische. Mit unkonventioneller Zuordnung von Farben zu Divergenzzeiten ergibt sich mit $f(z) = (-2.6-i) \cosh(z)$ dieses Bild:
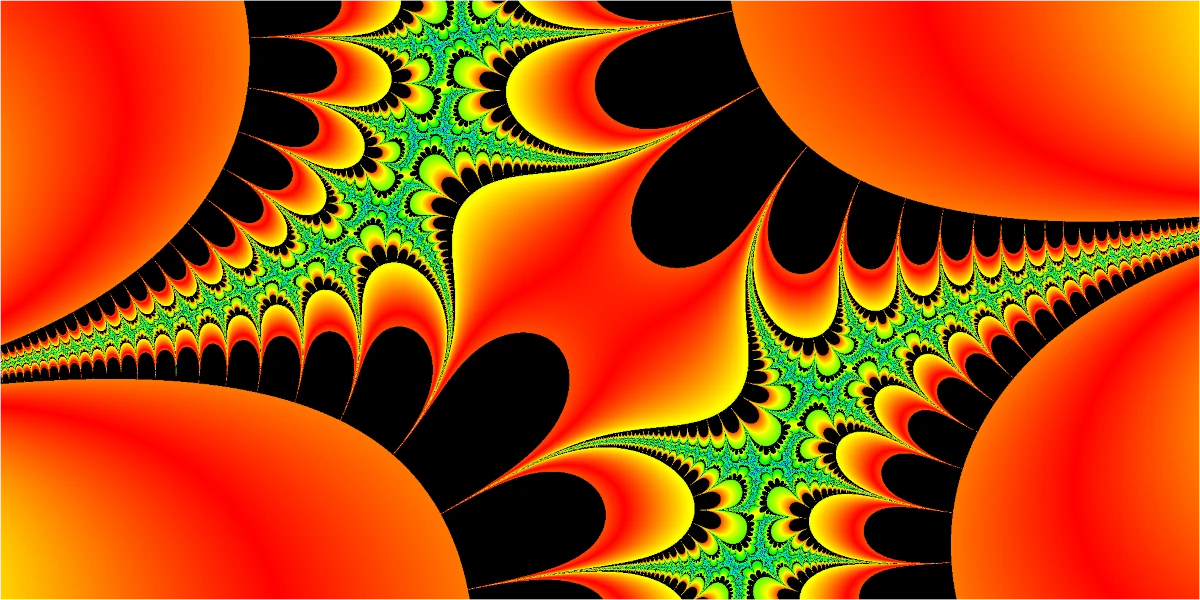
Ein weiteres Julia-Fraktal

Newton-Fraktal

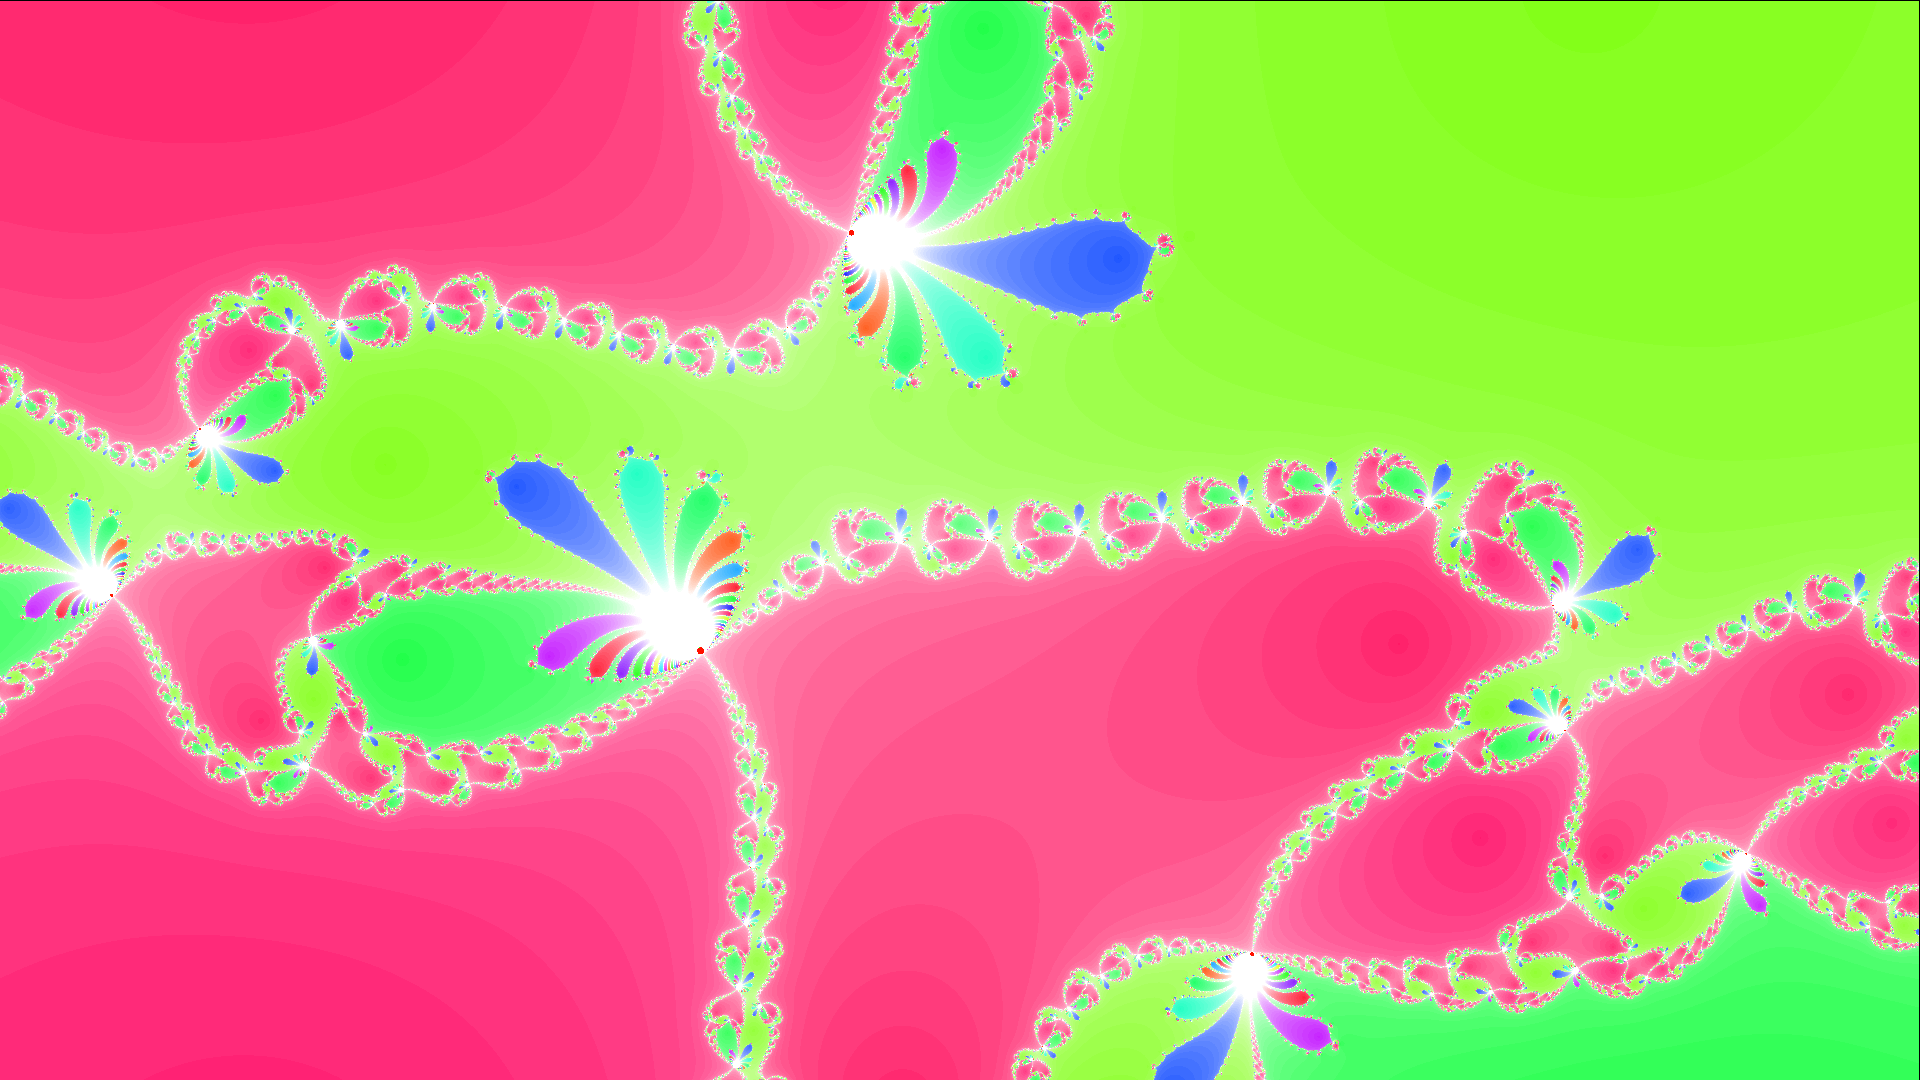
Das Newton-Verfahren zur Findung von Nullstellen startet an einem beliebigen Punkt auf einer Kurve, und berechnet die Nullstelle der Tangente an diesem Punkt. Mit der Tangente dieses Punktes wird genauso verfahren. Dabei sollten sich die so erhaltenen Punkte immer dichter einer Nullstelle nähern. Bei einer komplexen Funktion können wir dies für jeden Startpunkt iterieren. Jeder Punkt wird gegen eine Nullstelle konvergieren, der wir eine Farbe zuordnen und den Punkt mit dieser Farbe einfärben. Wenn wir die Sättigung davon abhängig machen, wie schnell die Konvergenz ist, sieht das Ergebnis für $f(x) = z^4 + 5^{z+i} + 15$ so aus.
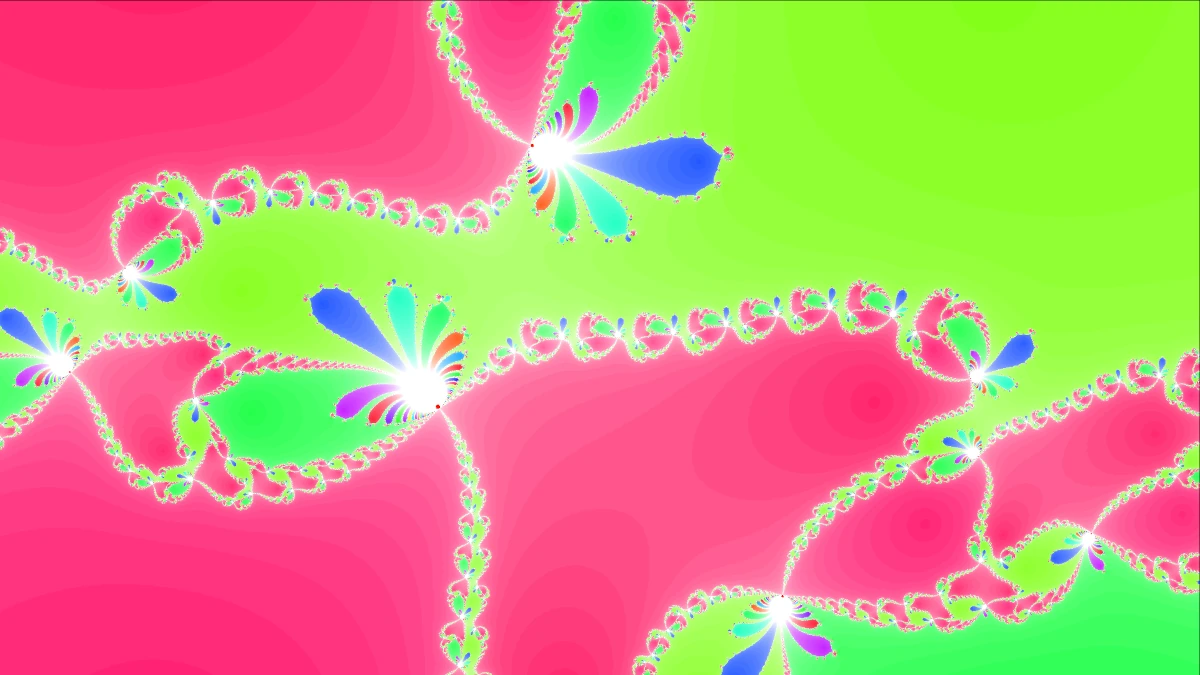
Newton Fraktal für f(x) = z^4 + 5^{z+i} + 15

Chaos Game

Eine große Klasse von Fraktalen lässt sich mit dem Chaos Game erzeugen. Man benutzt dazu mindestens zwei Abbildungen $f_1(z)$ und $f_2(z)$, die jeweils einen Punkt $z$ auf einen anderen Punkt abbilden. Man wählt einen Punkt zum Starten, bildet ihn mit einer Zufälligen der beiden Abbildungen ab, zeichnet den resultierenden Punkt ein und wiederholt dies sehr oft.

Dieser Algorithmus ist inherent sequenziell, allerdings kann man parallel an vielen verschiedenen Punkten starten und die Ergebnisse dieser unabhängigen Markovketten in einem Bild zusammenführen.

In Rust könnte der entsprechende Codeschnipsel so aussehen:

extern crate num_cpus;
use std::thread;
use std::sync::mpsc::channel;

let cpus = num_cpus::get();

// create a transmitter, receiver pair
let (tx, rx) = channel();
for _ in 0..cpus {
    // clone a transmitter for each thread
    let tx = tx.clone();

    // generator yielding the points from the chaos game
    // using a random seed
    let sampler = get_sampler();

    // we need some histogram implementation
    let mut hist = Histogram::new();

    thread::spawn(move || {
        // feed the samples into the histogram
        hist.feed(sampler.take(iterations_per_task));
        // send the finished histogram to the receiver
        tx.send(hist).unwrap();
    });
}

// collect all parallel computed histograms into main_hist
let mut main_hist = Histogram::new();
for _ in 0..cpus {
    let h = rx.recv().unwrap();
    main_hist.merge(&h);
}

Sierpinski-Dreieck und Barnsley-Farn

Mit dieser Methode kann man alte Bekannte wie das Sierpinski-Dreieck erzeugen.
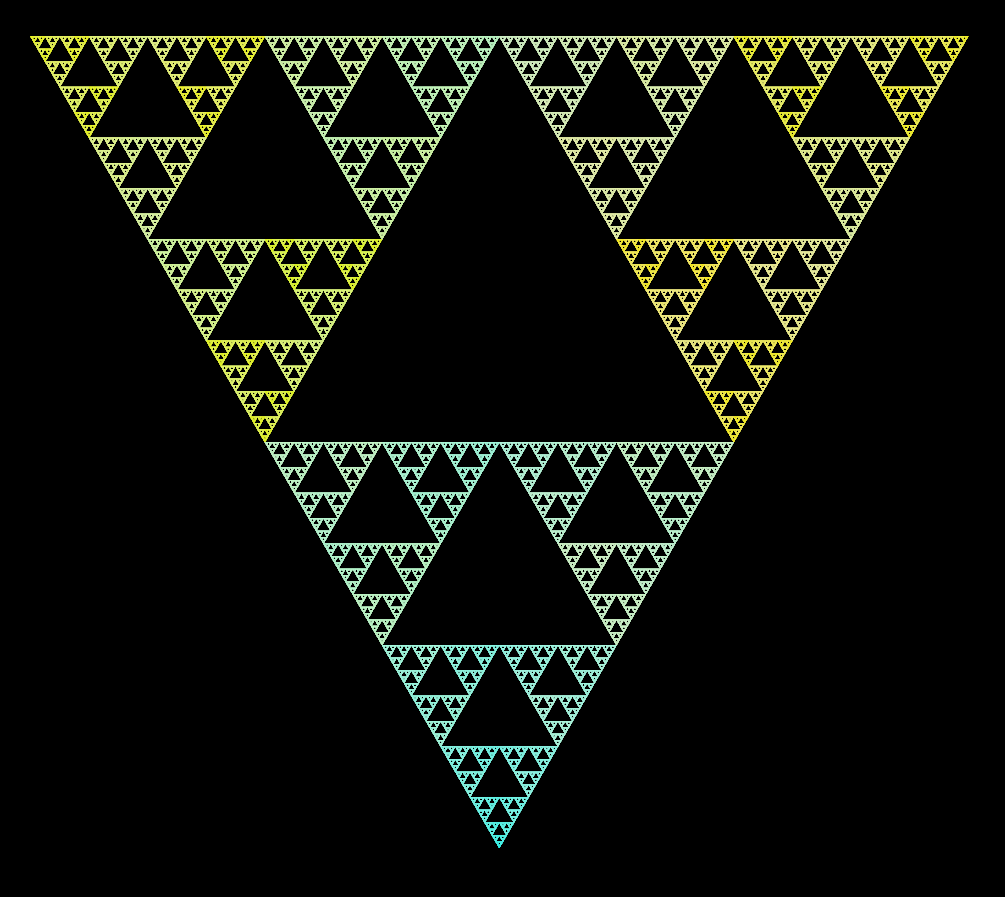
Sierpinski-Dreieck

Dazu benötigt man die drei affinen Transformationen, die man alle mit gleicher Wahrscheinlichkeit auswählt: $$\begin{align} f_1(\vec z) &=\begin{pmatrix} -1/4 & \sqrt 3 / 4 \ -\sqrt 3 / 4 & -1/4 \end{pmatrix} \cdot \begin{pmatrix} z_x \ z_y \end{pmatrix} + \begin{pmatrix} -1/4\ \sqrt 3 / 4 \end{pmatrix}\ f_2(\vec z) &=\begin{pmatrix} 1/2 & 0 \ 0 & 1/2 \end{pmatrix} \cdot \begin{pmatrix} z_x \ z_y \end{pmatrix} + \begin{pmatrix} 1/4\ \sqrt 3 / 4 \end{pmatrix}\ f_3(\vec z) &=\begin{pmatrix} -1/4 & -\sqrt 3 / 4 \ \sqrt 3 / 4 & 1/4 \end{pmatrix} \cdot \begin{pmatrix} z_x \ z_y \end{pmatrix} + \begin{pmatrix} 1\ 0 \end{pmatrix} \end{align}$$

Ein anderes berühmtes Beispiel ist der Barnsley-Farn. Um ihn zu erzeugen, benutzt man die folgenden vier affinen Abbildungen, die man mit den Wahrscheinlichkeiten $$p_1 = 0.01, p_2 = 0.85, p_3 = 0.07, p_4 = 0.07$$ verwendet: $$\begin{align} f_1(z) &=\begin{pmatrix} 0.16\ 0 \end{pmatrix}\ f_2(z) &=\begin{pmatrix} 0.85 & 0.04 \ 0 & -0.04 \end{pmatrix} \cdot \begin{pmatrix} z_x \ z_y \end{pmatrix} + \begin{pmatrix} 0.85\ 1.6 \end{pmatrix}\ f_3(z) &=\begin{pmatrix} 0.2 & -0.26 \ 0 & 0.23 \end{pmatrix} \cdot \begin{pmatrix} z_x \ z_y \end{pmatrix} + \begin{pmatrix} 0.22\ 1.6 \end{pmatrix}\ f_4(z) &=\begin{pmatrix} -0.15 & 0.28 \ 0 & 0.26 \end{pmatrix} \cdot \begin{pmatrix} z_x \ z_y \end{pmatrix} + \begin{pmatrix} 0.24\ 0.44 \end{pmatrix}\ \end{align}$$

Als Ergebnis erhält man diesen Farn.
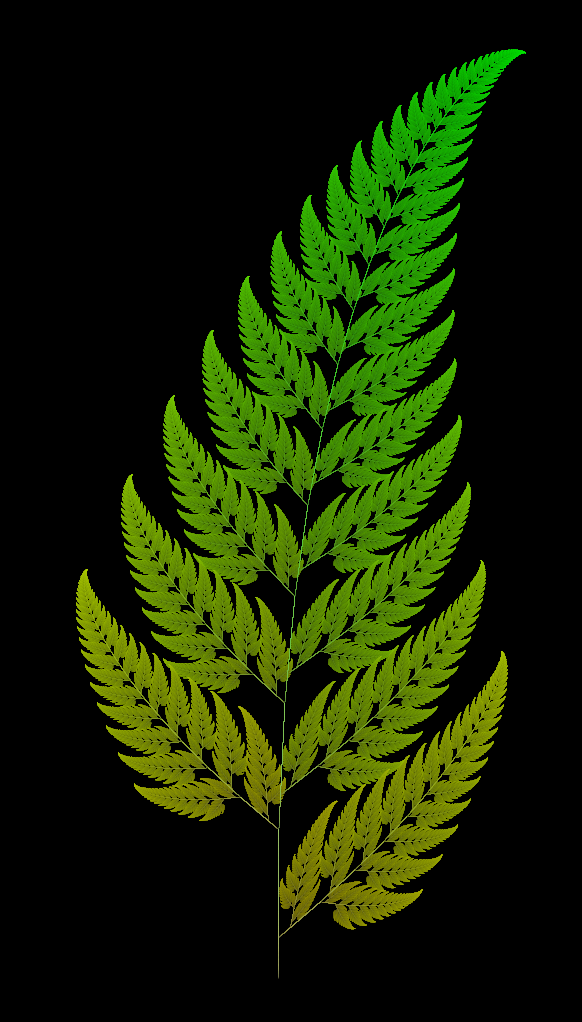
Bernsley-Farn

Fractal Flame

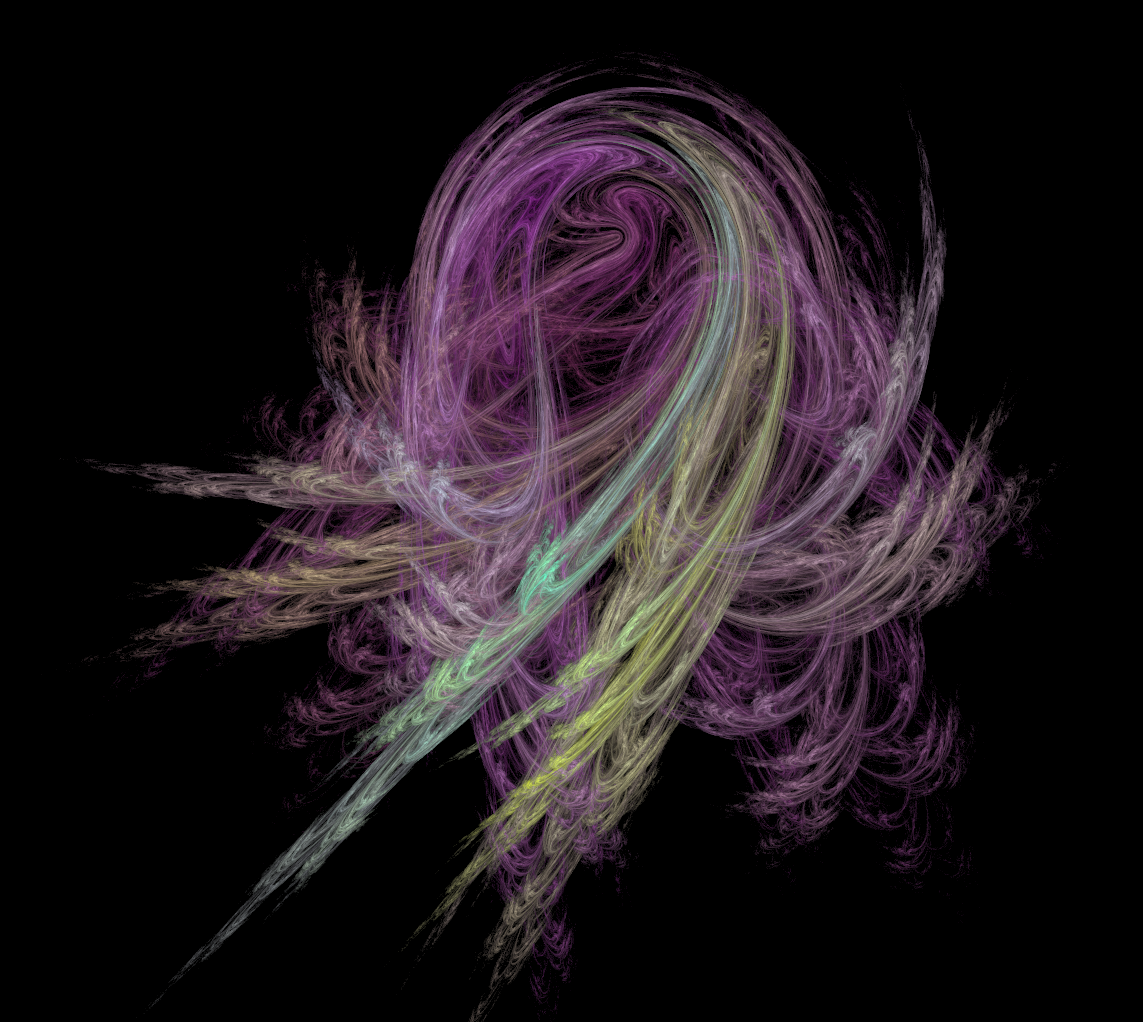
Fractal Flame ist der Name einer Klasse von Zufallsfraktalen, die nach dem gleichen Muster wie oben aus einer Reihe affiner Transformationen $A_i$ bestehen. Zusätzlich können die affinen Transformationen mit einer nichtlinearen Variation $V_j$ erweitert werden, sodass $f_i(\vec z) = V_j(A_i(\vec z))$ (oder Linearkombinationen dieser Variationen). Zur Visualisierung werden die Punkte nicht direkt gezeichnet, sondern in ein Histogramm eingetragen, aus dem die Farbintensitäten typischerweise logarithmisch berechnet werden.
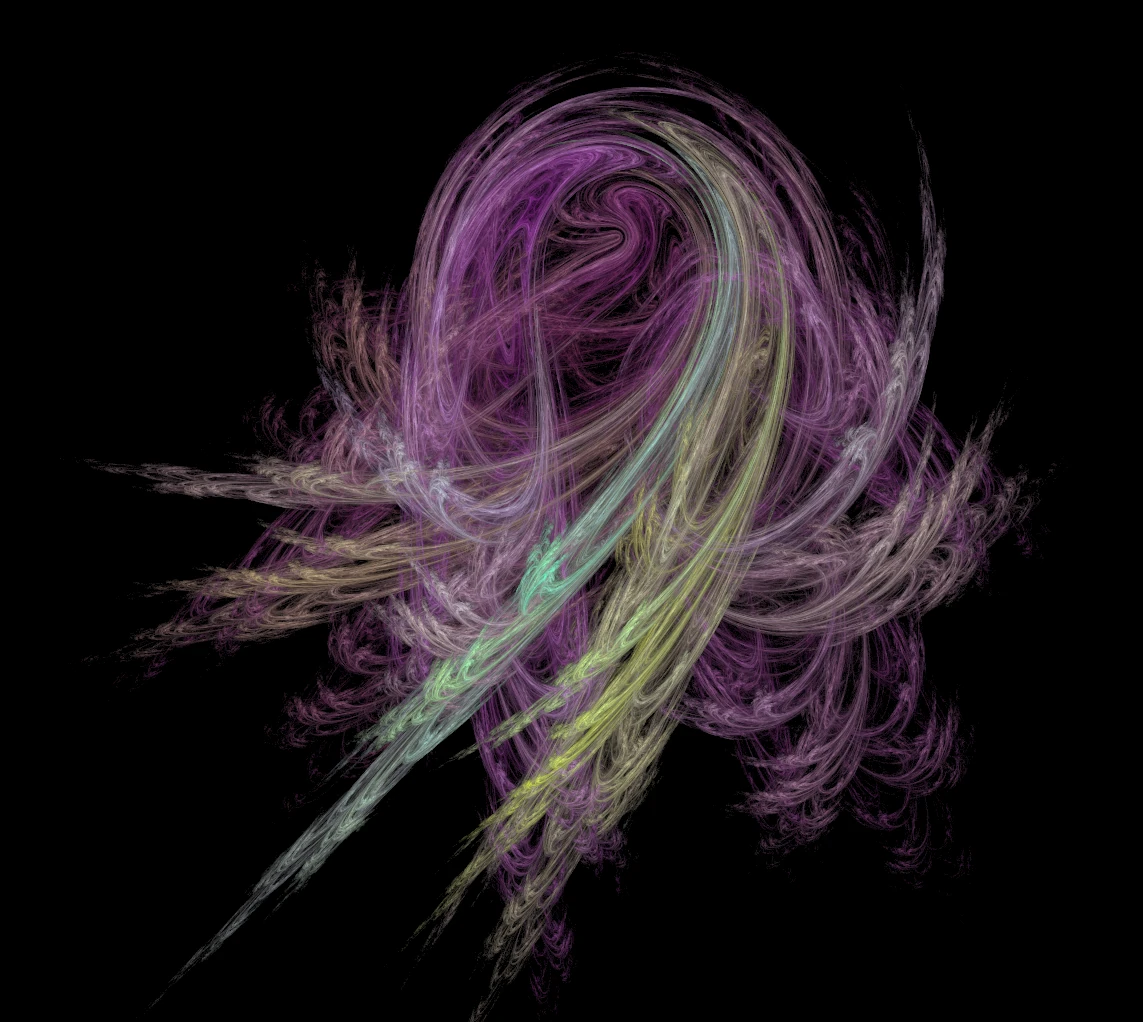
Fractal Flame, 'Horseshoe' Variation

Hier wird jedem $f_i$ ein Farbton zugeordnet. Die Farbe eines Punktes ist eine Mischung dieser Farben, die widerspiegelt, wie oft eine Abbildung genutzt wurde, um an diesen Punkt zu gelangen.

Interessanterweise sind diese Systeme anscheinend sehr anfällig für schlechte Zufallszahlen, was sich in „Löchern“ in den ansonsten glatten Flächen bemerkbar macht.

Möbius Flame

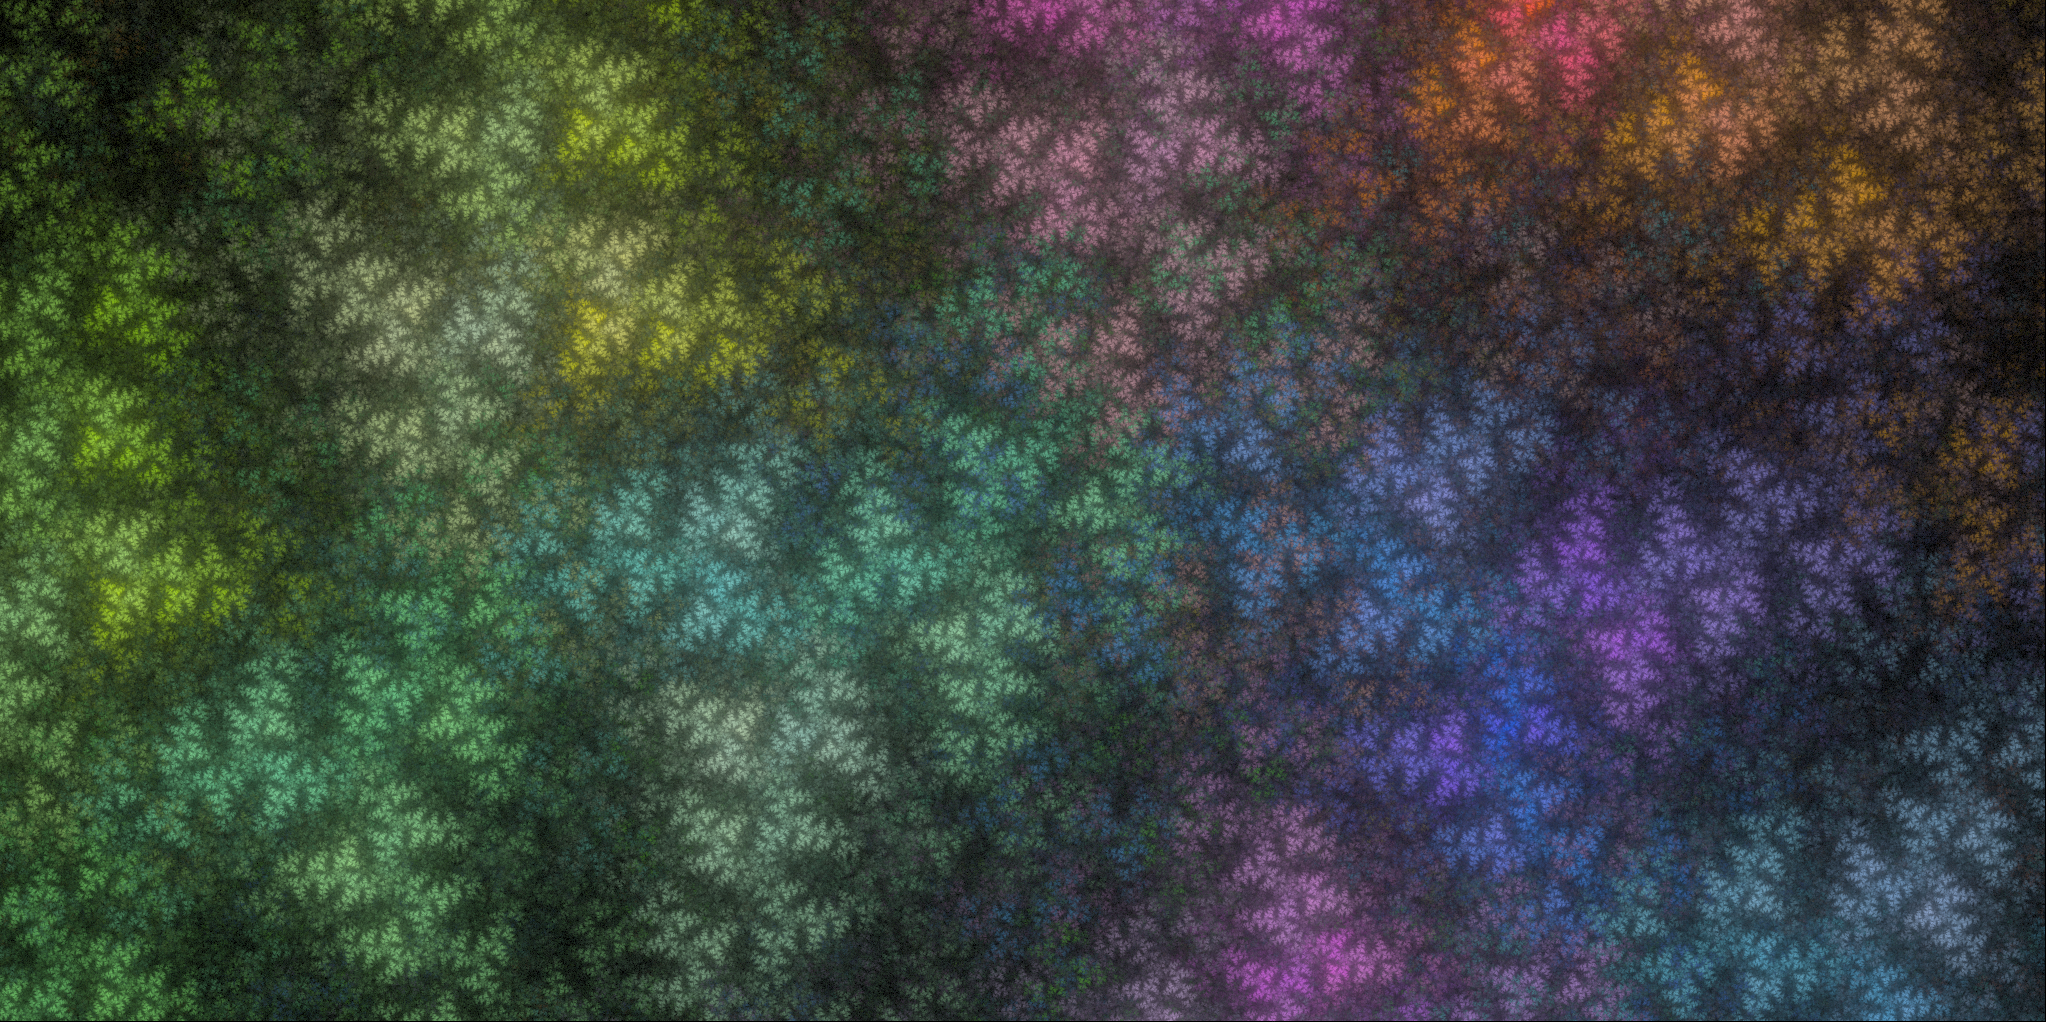
Diese Fraktale sind nahezu identisch zu den Fractal Flames, nur dass anstatt von affinen Transformationen Möbius Transformationen auf der komplexen Ebene genutzt werden.

$$f_i(z) = \frac{a_i z + b_i}{c_i z + d_i}$$
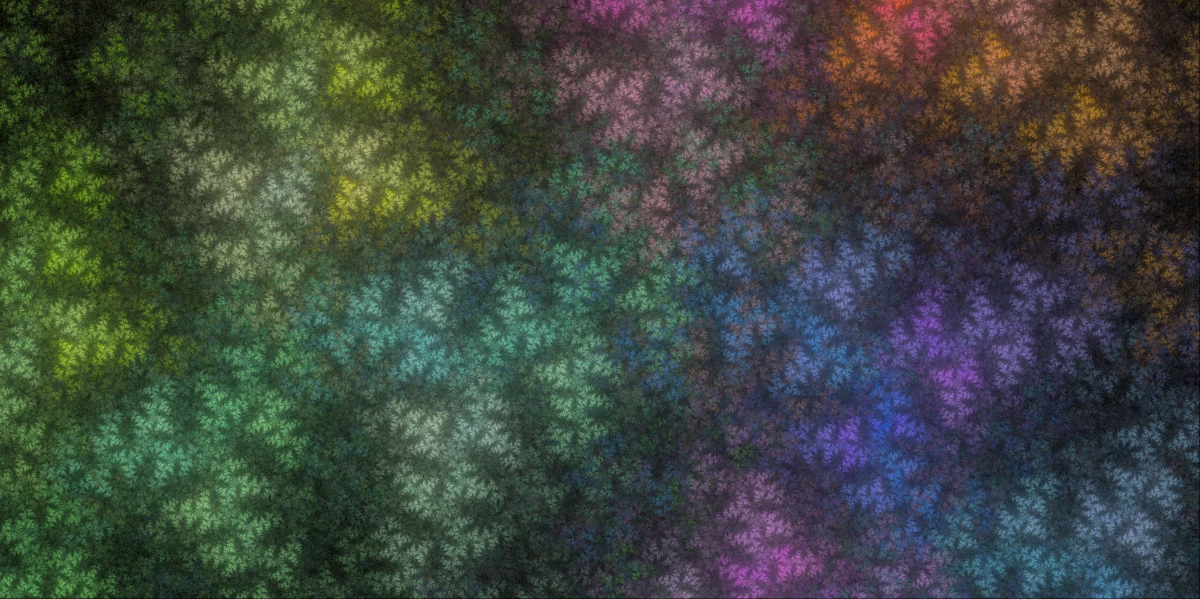
Möbius Flame

Wie findet man „gute“ Parameter?

Offenbar hat dieser Typ von Fraktal sehr viele freie Parameter. Um hübsche Resultate zu generieren, müssen sie angepasst werden. Tatsächlich gibt es mit electric sheep (ich hoffe stark, dass es eine Blade Runner Referenz ist) ein Crowdsourcing-Projekt, das mithilfe von evolutionären Algorithmen und dem Feedback von Menschen besonders ansehnliche Fraktale erzeugt.

Für mein Programm habe ich eine simplere Methode genutzt. Damit man ein Fraktal gut sehen kann, sollte seine fraktale Dimension größer als 1 sein. Abschätzbar ist es relativ einfach über die Korrelations-Dimension. Dazu misst man die paarweisen Abstände von Punkten und misst den Exponenten ihrer kumulativen Verteilungsfunktion.

Kombiniert mit einigen Heuristiken, die zu langgestreckte Fraktale verhindert, sind die Ergebnisse meist ansprechend

Weitere Fraktale

Es gibt natürlich viel mehr Typen von Fraktalen. Auch wenn @AFractalADay sie bisher nicht zeichnen kann, habe ich einige Bilder angefertigt, die ich hier auch gerne zeigen möchte.

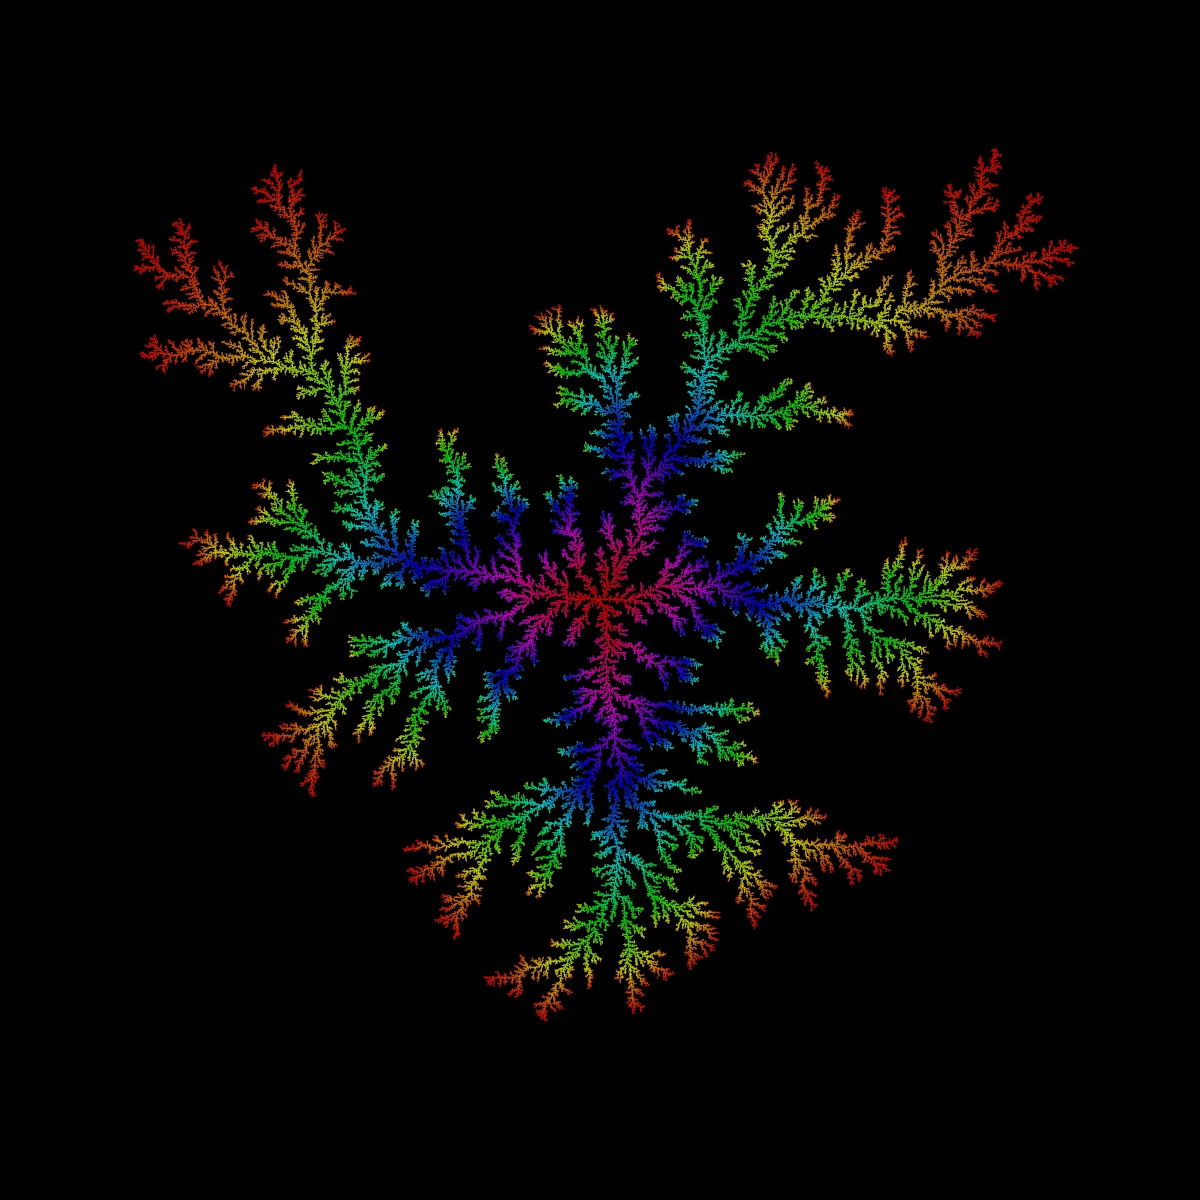
Diffusionsbegrenztes Wachstum

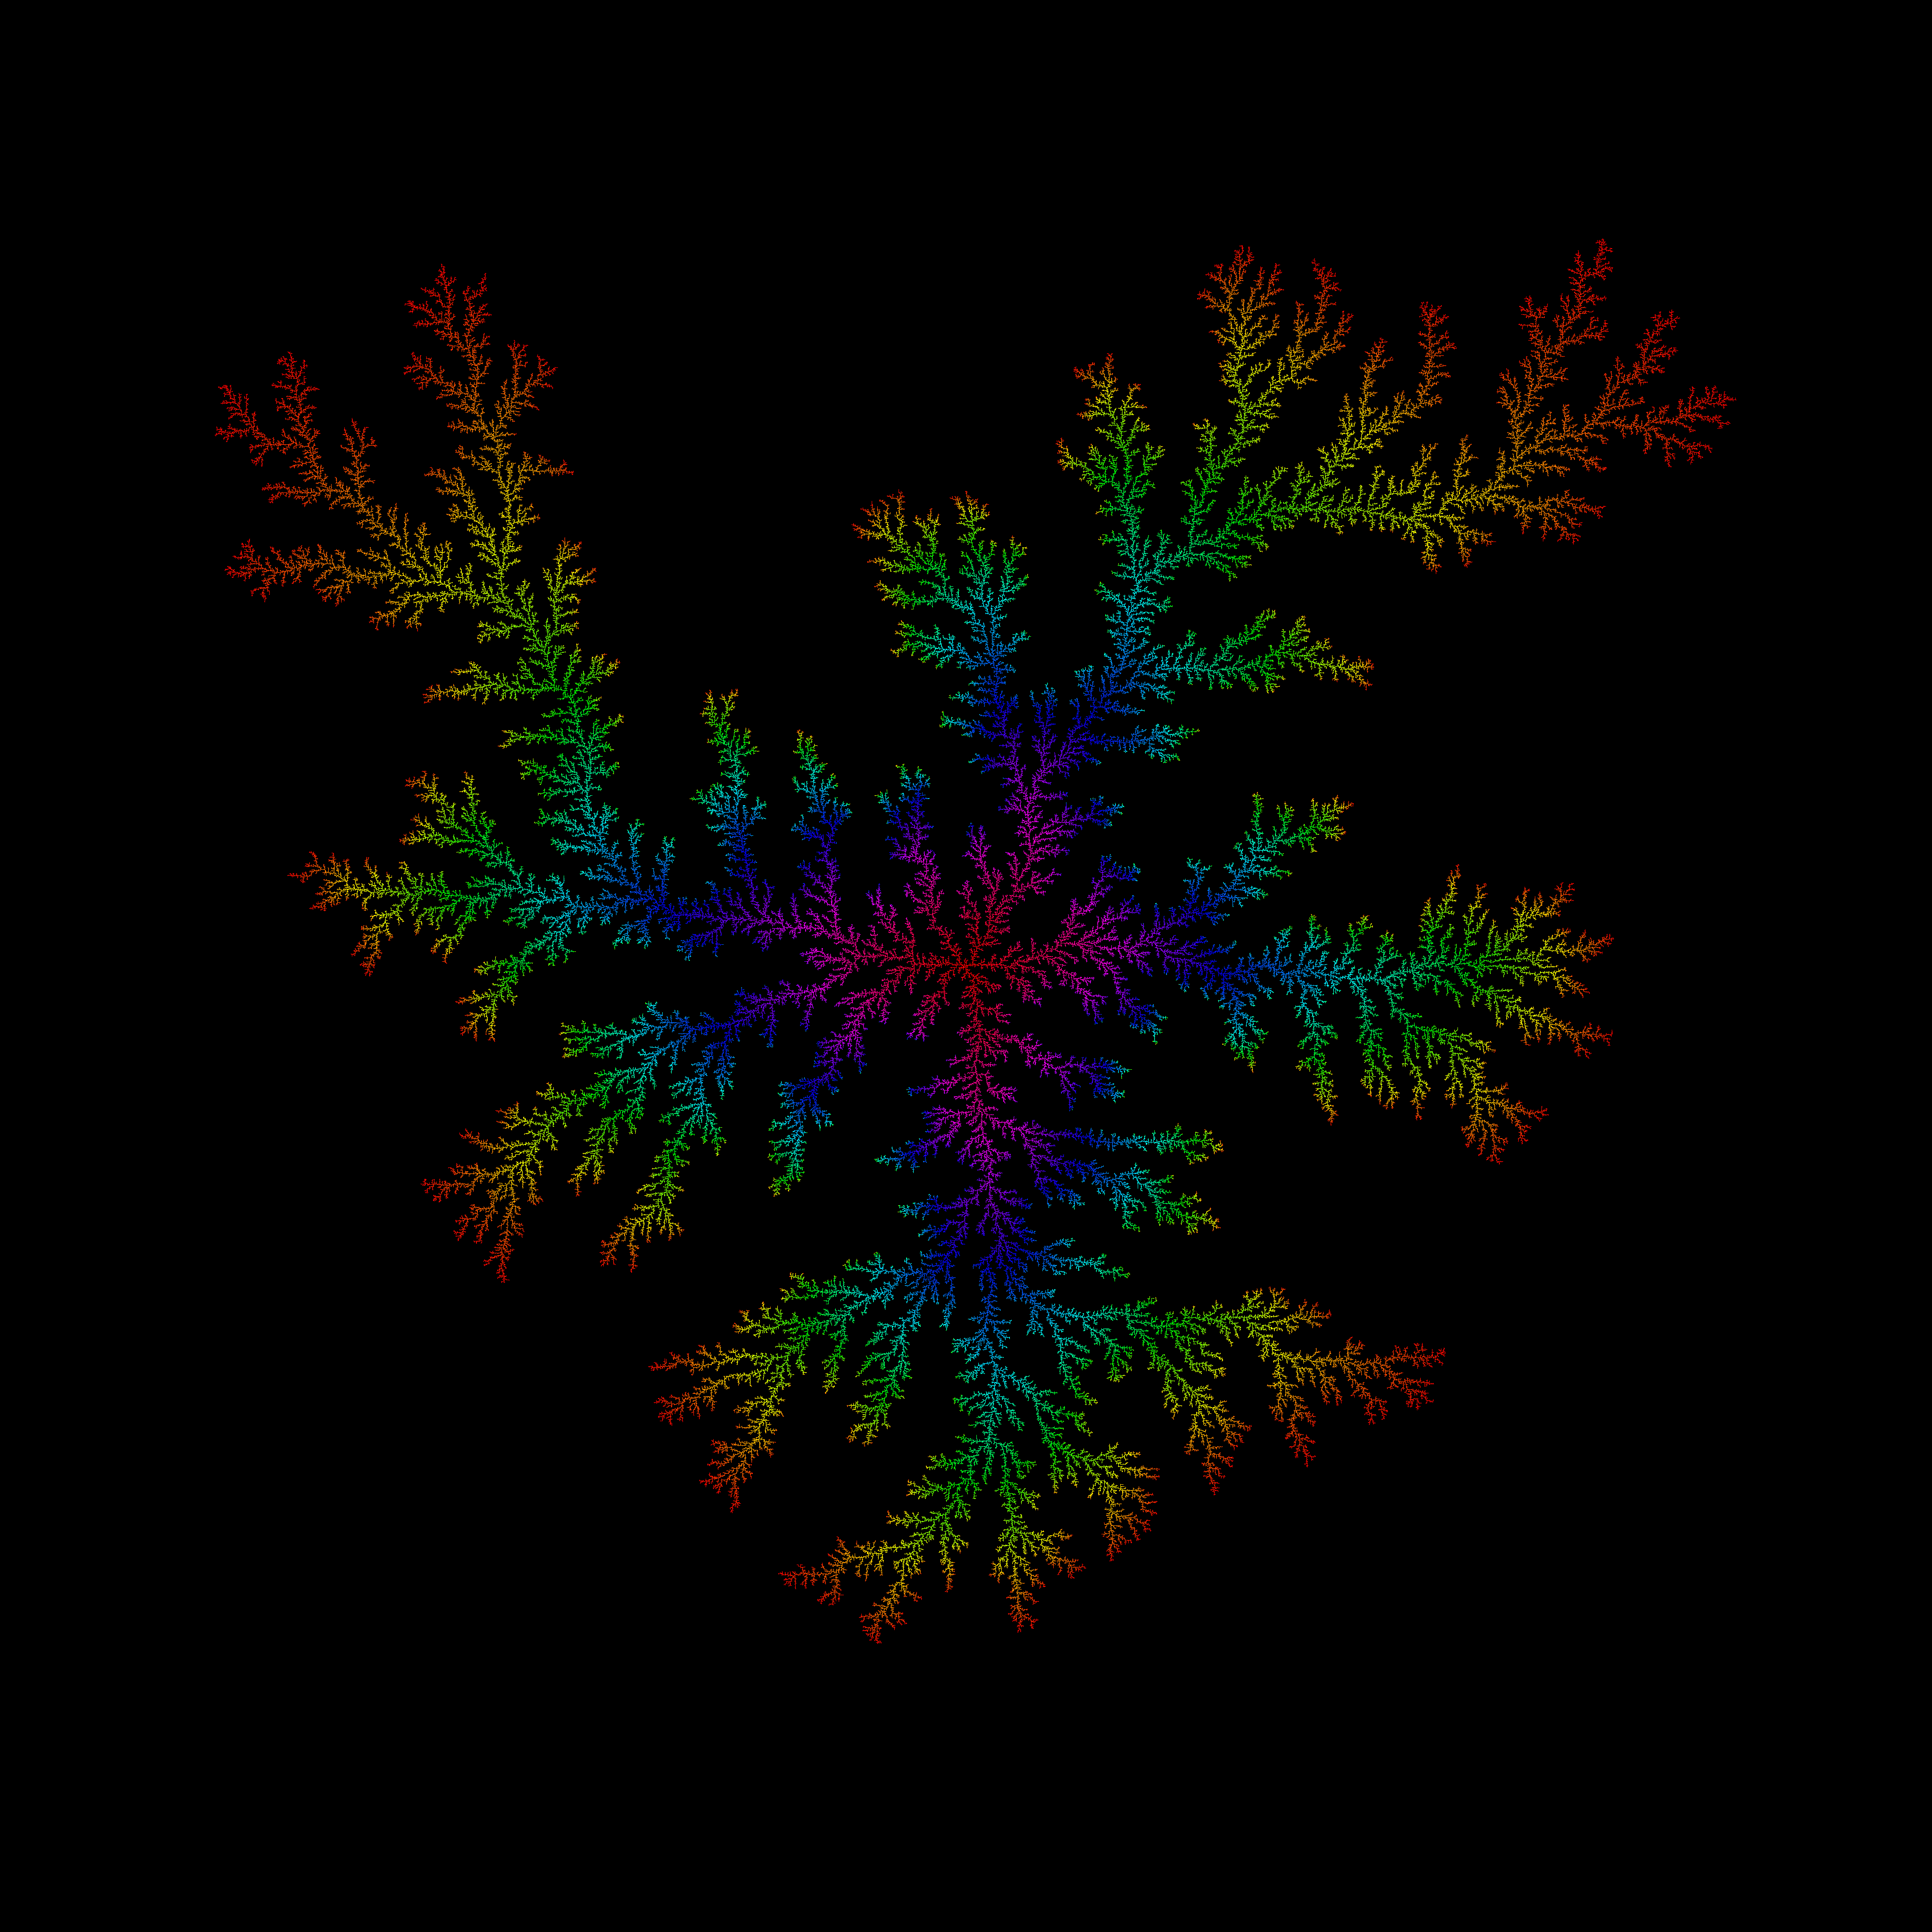
Diffusionsbegrenztes Wachstum bildet das Wachstum von Kristallen in stark verdünnten Lösungen ab. Man startet mit einem Seed und lässt dann einzelne Teilchen diffundieren, bis sie auf dem Nachbarfeld eines Seeds landen, wo sie dann bleiben und Teil des Seeds werden. Dieser Prozess bildet verästelte Strukturen aus.
Diffusionsbegrenztes Wachstum

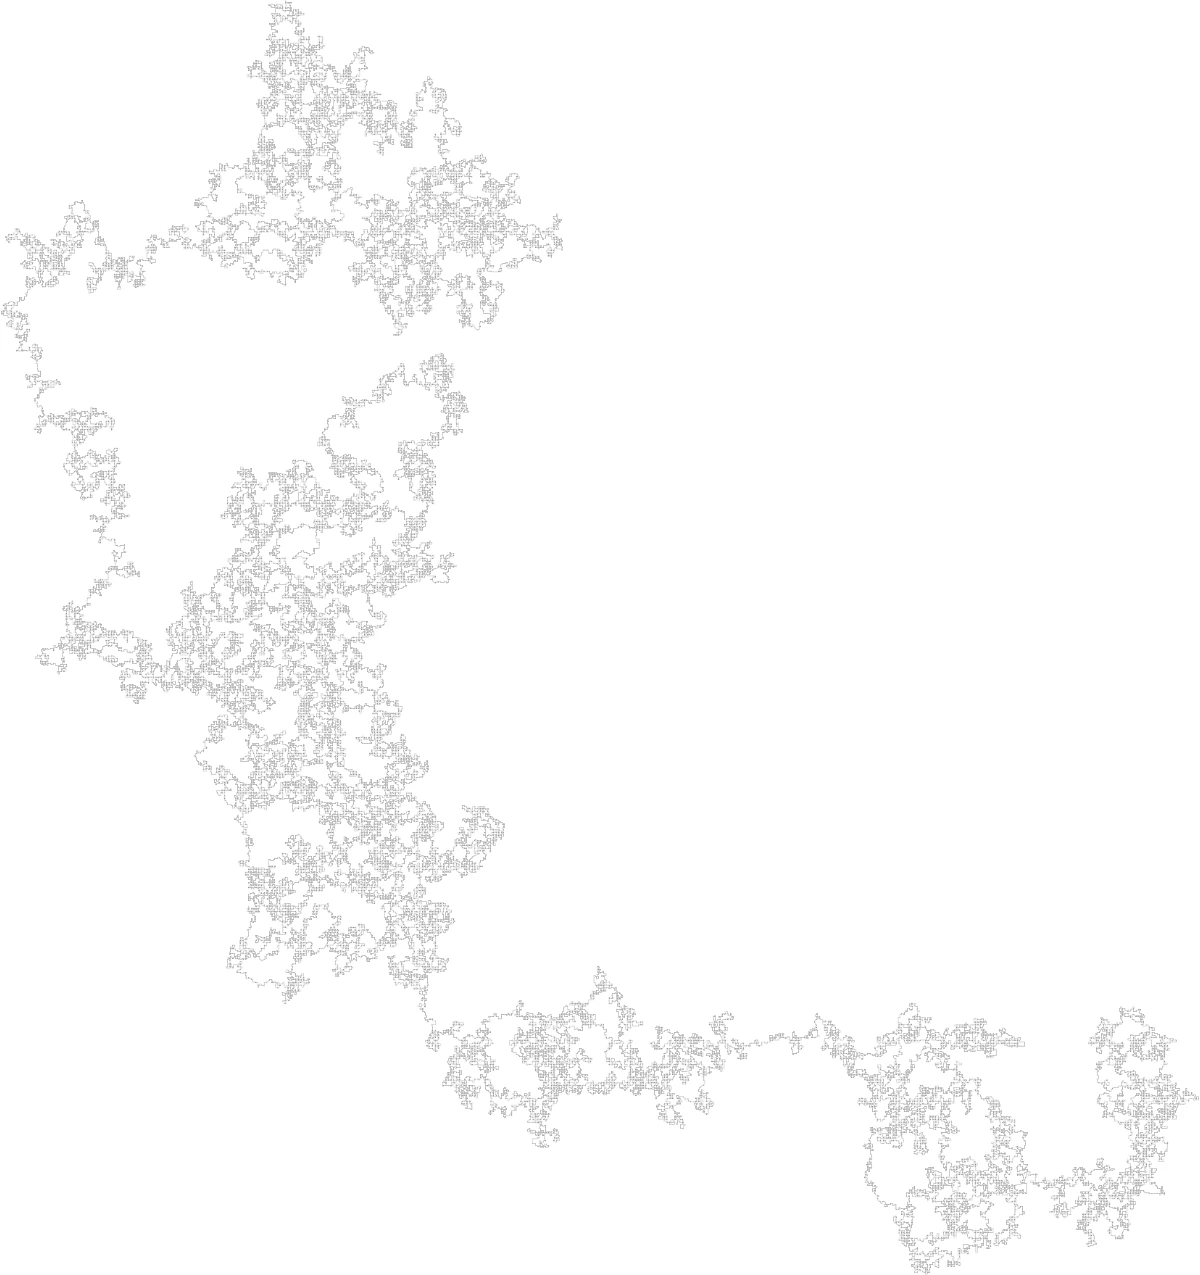
Random Walks

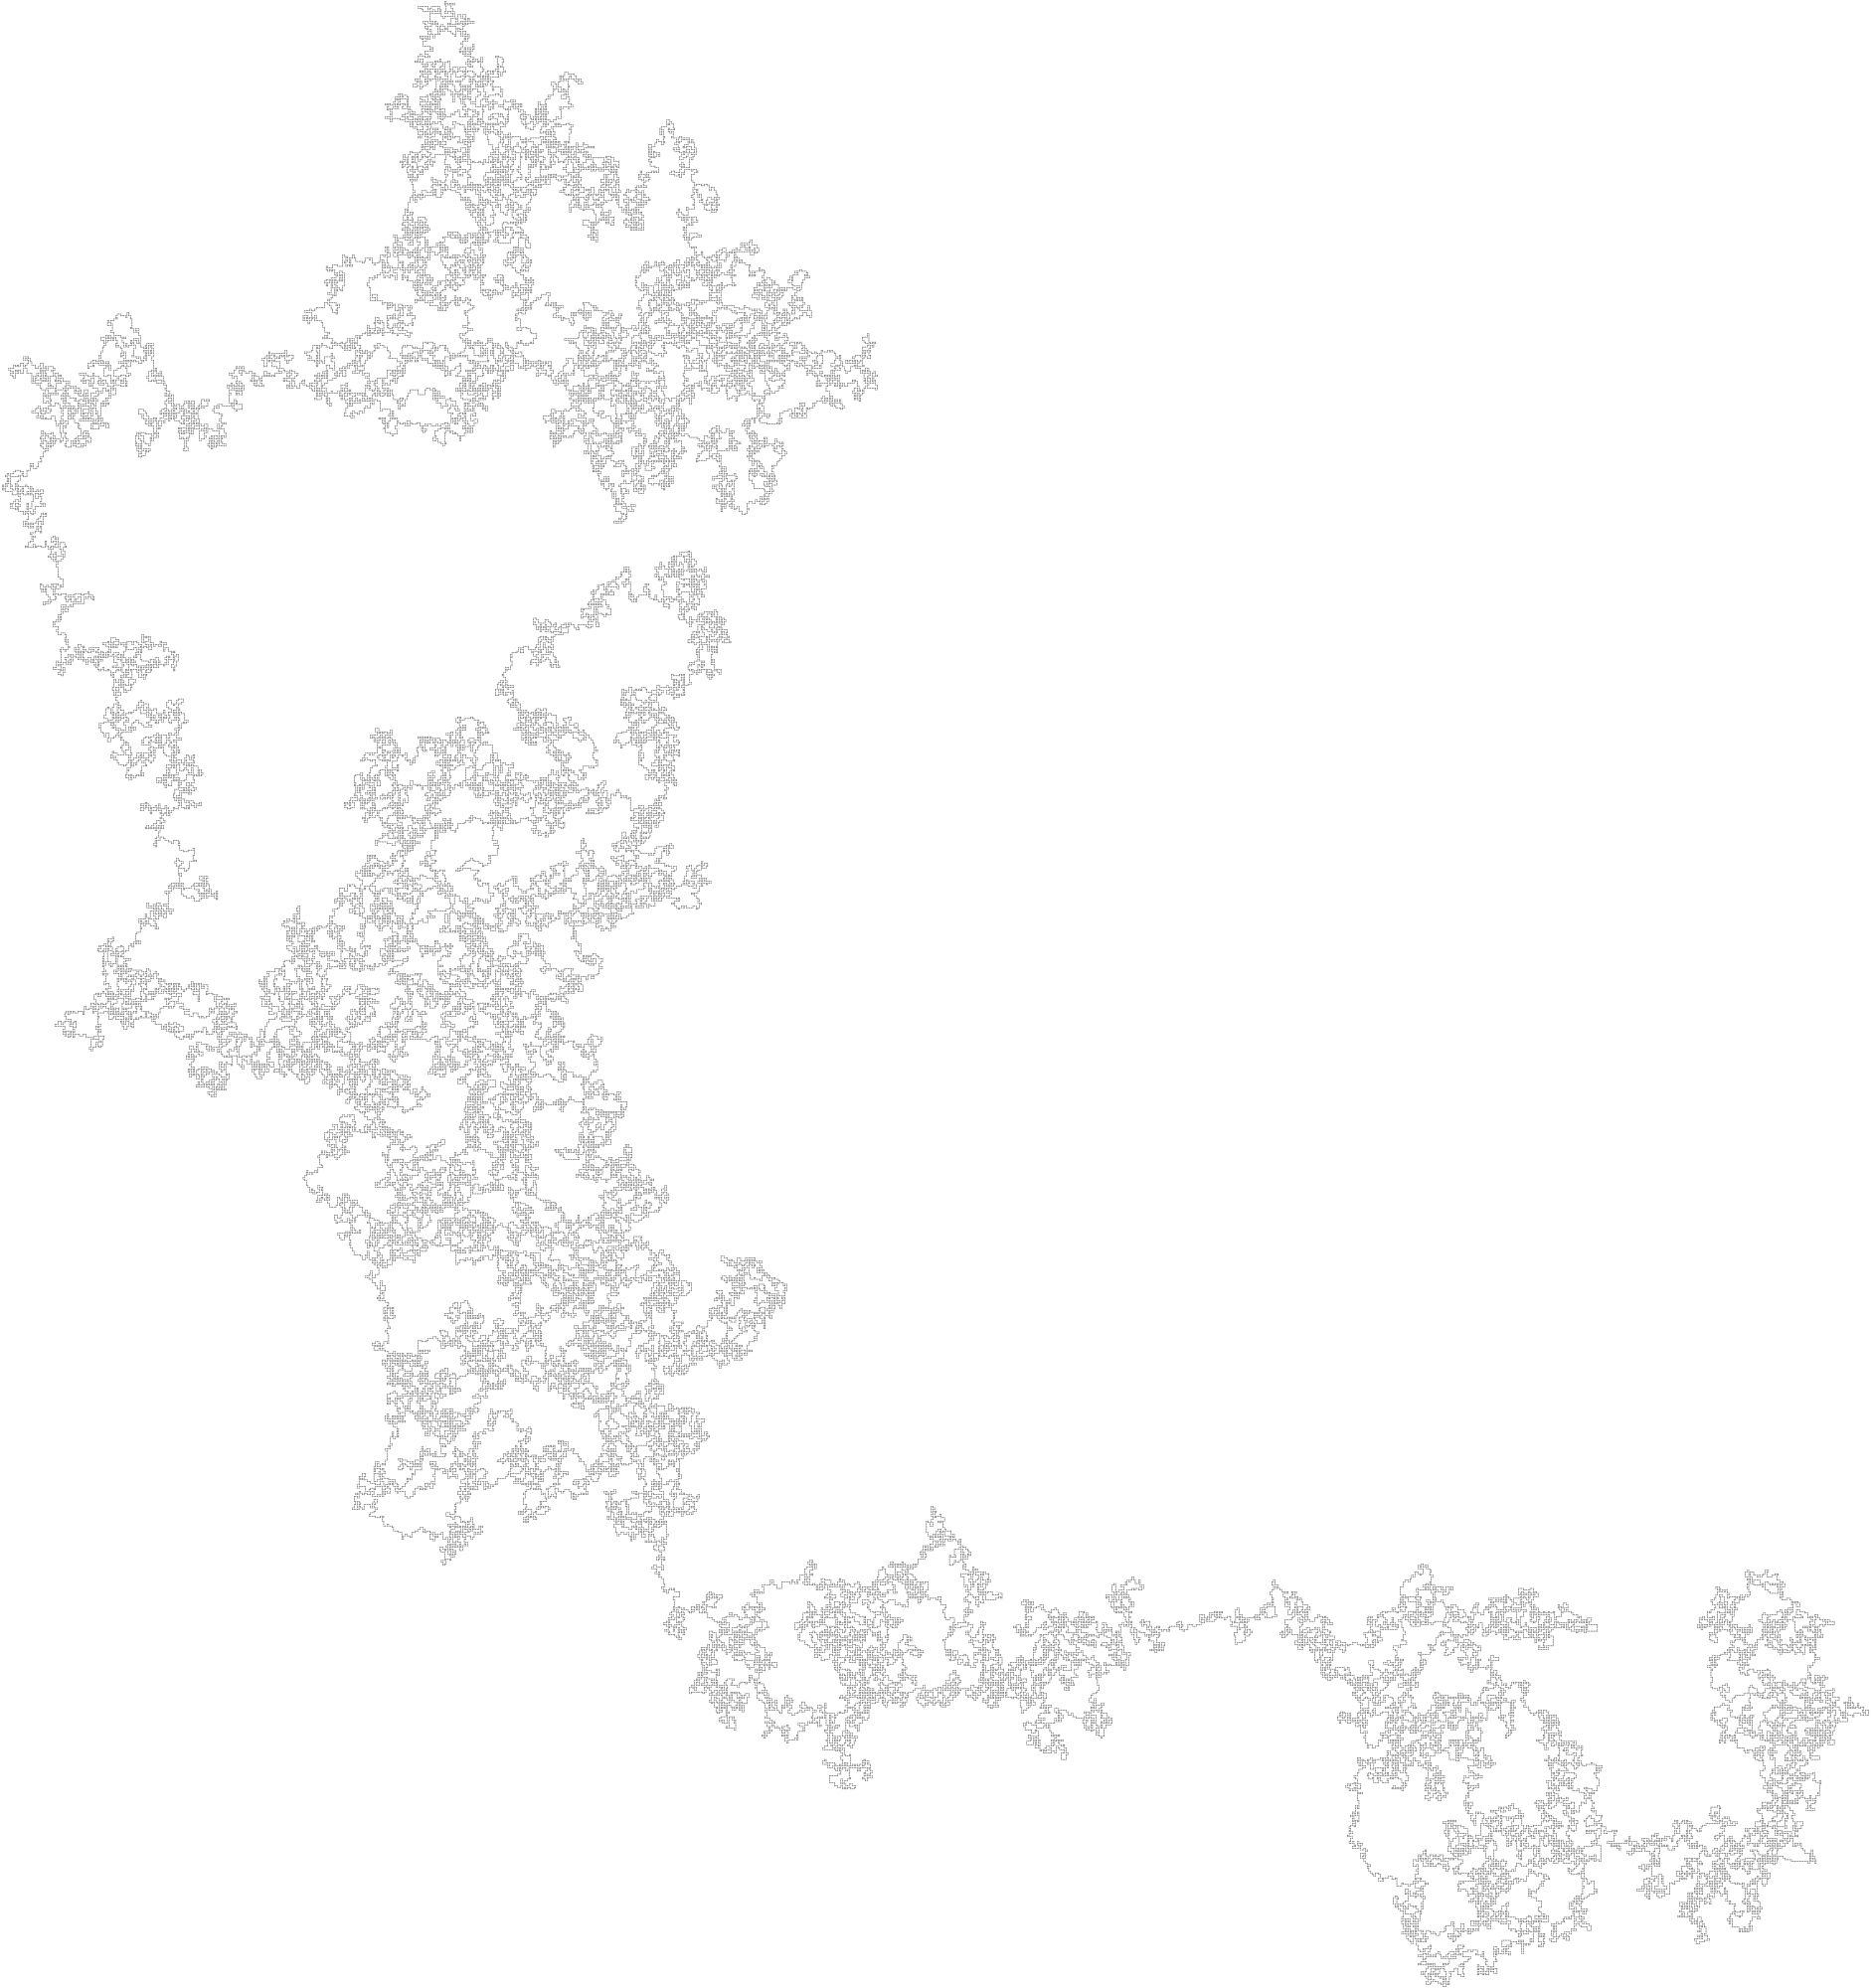
Einige Arten von Random Walks haben eine fraktale Dimension zwischen 1 und 2, was sie zu ansehnlichen Fraktalen machen sollte. Der Smart Kinetic Self Avoiding Walk, der in meinem rsnake die Strategie des Autopiloten ist, hat eine fraktale Dimension von $\frac{7}{4}$. 100000 Schritte sehen so aus:
Smart Kinetic Self Avoiding Walk, 100000 Schritte